Reflection AIs Beam, erklärt: das Open-Weight-Modell, das früh angekündigt wurde und zwei Wochen später tatsächlich erschien
Reflection AI, ein von Nvidia und Sequoia finanziertes Startup, gegründet von zwei ehemaligen Google-DeepMind-Forschern, kündigte am 5. Oktober 2026 sein erstes Open-Weight-Modell Beam an, zunächst nur mit einer Warteliste zum Vorweisen. Der Großteil der noch online stehenden Berichterstattung wurde in genau dieser Lücke geschrieben, als „Open-Weight" noch ein Versprechen war und kein Download. Reflection lieferte die Gewichte, einen Sicherheitsbericht und API-Zugang über mehr als 40 Partner tatsächlich erst am 16. Oktober aus. Hier steht, was Beam ist, wie es sich gegen die chinesischen Open-Modelle schlägt, gegen die es positioniert wird, und ob die Lücke zwischen Ankündigung und Release etwas daran ändert, wie sehr man dem Rest der Behauptungen trauen sollte.
Beam ist ein Sparse-Mixture-of-Experts-Modell mit 501 Milliarden Parametern (23 Milliarden aktiv pro Token) von Reflection AI, angekündigt am 5. Oktober 2026 und am 16. Oktober als offene Gewichte unter Apache 2.0 veröffentlicht. Die Gewichte sind auf Hugging Face in BF16, FP8 und NVFP4 verfügbar, mit einer eigenen API in der Public Beta und mehr als 40 Launch-Partnern, darunter AWS, Google Cloud, Oracle, Cloudflare und OpenRouter.
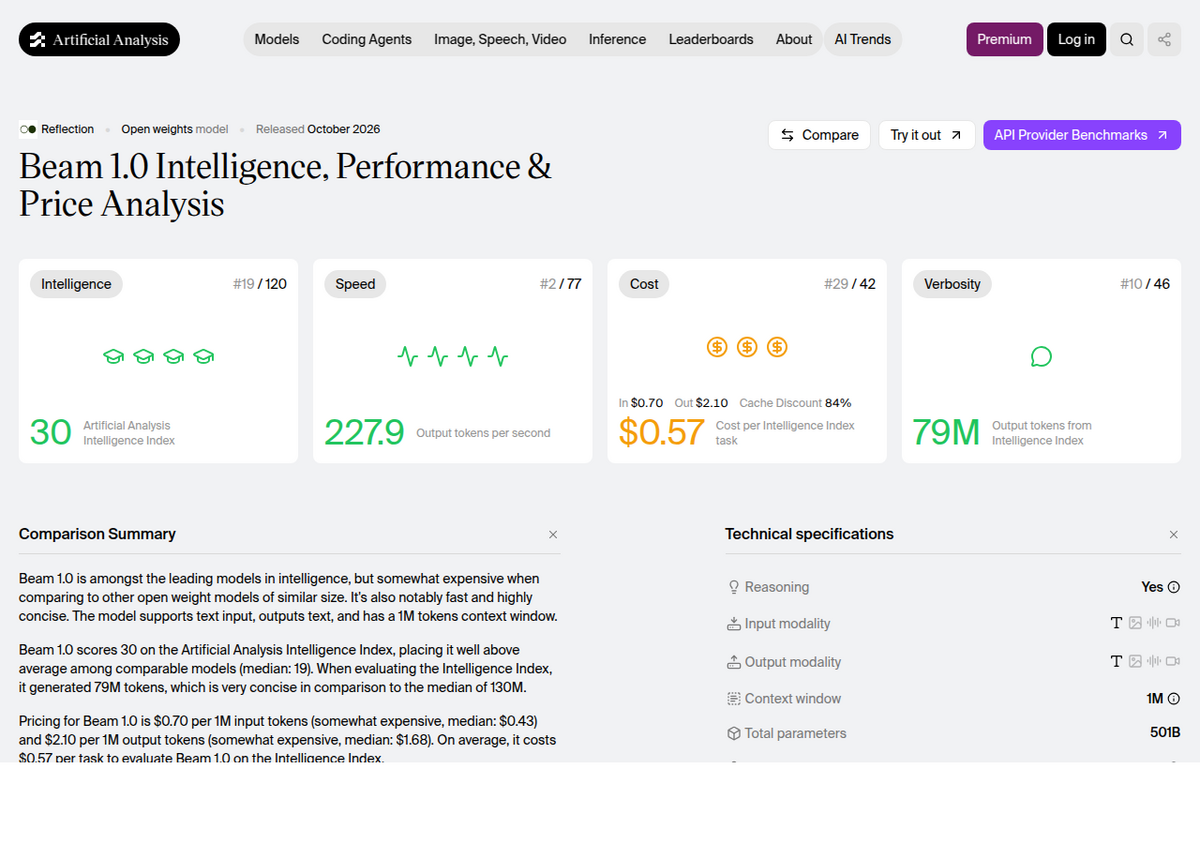
Unabhängig gemessen erreicht es 30 Punkte auf Artificial Analysis' Intelligence Index (Median für vergleichbare Modelle: 19), Rang 19 von 120 zum Zeitpunkt dieses Texts erfassten Modellen. Es ist schnell (227,9 Output-Tokens pro Sekunde, Platz 2 von 77 gemessenen Modellen) und pro Aufgabe relativ günstig, aber es ist nicht das stärkste verfügbare Open-Weight-Modell: Moonshots Kimi K3 schlägt es bei den meisten Reasoning- und Agenten-Benchmarks, und das räumt Reflections eigene veröffentlichte Tabelle selbst ein.
Es braucht ernsthafte Hardware. Bei BF16 sind allein die Gewichte rund 1 TB groß; selbst bei FP8 braucht man etwa einen einzelnen 8xH200-Knoten. Auf einem Laptop oder einer einzelnen Consumer-GPU lässt sich das realistisch nicht betreiben.
Es hat nichts mit der „Reflection 70B"-Kontroverse von 2024 zu tun, bei der sich herausstellte, dass das gehostete „70B"-Modell eines anderen Unternehmens Anfragen heimlich an Claude weiterleitete. Reflection AI (gegründet 2024 von Misha Laskin und Ioannis Antonoglou) ist ein unabhängiges, unverwandtes Unternehmen, eine Verwechslung, die in Entwicklerforen oft genug auftaucht, um sie klar festzuhalten.
Was Beam tatsächlich ist
Beam ist ein Sparse-Mixture-of-Experts-Modell: 501 Milliarden Parameter insgesamt, von denen aber nur 23 Milliarden für ein beliebiges Token aktiviert werden, verteilt über 52 Layer mit verschachtelter lokaler und globaler Attention und einem Lastausgleich zwischen den Experten ohne zusätzlichen Hilfsverlust (aux-loss-free). Es ist rein textbasiert, sowohl bei Ein- als auch Ausgabe: keine Bildgenerierung, und visuelle Inhalte kann es nur verarbeiten, wenn sie vorher von etwas anderem in Text umgewandelt wurden. Reflections eigene Ankündigung beschreibt es als klar auf Coding, Reasoning und agentische Arbeit ausgerichtet, nicht auf allgemeinen Chat.
Den Pretraining-Daten widmet Reflection die meisten Worte. Das Unternehmen sagt, man sei vom üblichen rohen Internet-Crawl ausgegangen und habe davon durch Kuratierung rund 95 % verworfen, sodass etwa 1,8 Billionen Tokens an dem übrig blieben, was Reflection als wirklich hochwertiges Material bezeichnet, das herkömmliche Filter übersehen hätten, eingebettet in einen Gesamt-Pretraining-Lauf von 23,8 Billionen Tokens. Das Kontextfenster beträgt 1 Million Tokens, diese Zahl wird aber erst durch einen Mid-Training-Erweiterungsschritt erreicht; die anschließende Reinforcement-Learning-Phase ist selbst auf 256.000 Tokens begrenzt, eine Unterscheidung, die man kennen sollte, wenn man Beam speziell für agentische Aufgaben mit sehr langem Kontext bewertet und nicht nur für lange einzelne Dokumente.
Der Trainingslauf, in Zahlen, die die meisten Modell-Ankündigungen nicht veröffentlichen
Reflection ist ungewöhnlich konkret darüber, wie Beam gebaut wurde, und die beiden Trainingsphasen liefen auf unterschiedlicher Hardware. Das Pretraining lief auf 6.144 Nvidia-GB300-NVL72-GPUs für unter vier Wochen, erreichte gegen Ende des Laufs 92,3 % Goodput (der Anteil der GPU-Zeit, der tatsächlich nutzbaren Trainingsfortschritt erzeugt), mit 9 halbautomatischen Rücksetzungen, ausgelöst durch Gradienten-Spitzen oder vermutete lautlose Datenkorruption. Reinforcement Learning lief anschließend separat auf 10.500 GB300-GPUs über vier Wochen und erzeugte mehr als 100 Millionen Rollouts, davon rund 80 Millionen gezielt für eine „Reasoning-Experten"-Teilkomponente. Auf dem Höhepunkt hielt der RL-Lauf im Schnitt rund 110.000 gleichzeitige Rollouts und bis zu 170.000 gleichzeitige Sandboxes, 1,3 Milliarden Sandbox-Aufrufe insgesamt gegenüber rund 1 Million überwiegend synthetischen RL-Umgebungen. Gewichts-Updates erreichten die Live-Inferenz-Flotte Berichten zufolge im Median nach etwa 12 Sekunden, und der Lauf überstand 71 Inferenz-Vorfälle, ohne das Training zu unterbrechen, mit einer medianen Erholungszeit von jeweils 8 Minuten.
Diese beiden GPU-Zahlen, 6.144 für Pretraining und 10.500 für RL, tauchen in verschiedenen Drittartikeln so auf, als würden sie sich widersprechen. Das tun sie nicht: Die eine ist der Pretraining-Cluster, die andere der deutlich größere Reinforcement-Learning-Cluster, der danach lief, und die beiden zu vermischen ist ein Fehler, auf den man achten sollte, wenn man andere Berichterstattung zu diesem Launch gegenprüft.
Angekündigt am 5. Oktober, tatsächlich veröffentlicht am 16. Oktober
Das ist das Detail, an dem die meiste bestehende Berichterstattung zu Beam veraltet, weil der Großteil genau in dieser Lücke geschrieben wurde. Reflections Ankündigung vom 5. Oktober öffnete frühen Zugang nur über eine Warteliste, wobei das Unternehmen sagte, Gewichte, ein technischer Bericht und Entwickler-Tools würden „in den kommenden Wochen" folgen, während das Modell noch das durchlief, was Reflection als abschließende Sicherheitsprüfungen bezeichnete. Elf Tage später veröffentlichte Reflection einen zweiten Beitrag, „Beam is now available", datiert auf den 16. Oktober 2026, der die vollständige Veröffentlichung bestätigte: offene Gewichte auf Hugging Face (Formate BF16, FP8 und NVFP4, plus ein separates Drafter-Modell für spekulatives Decoding), eine bestätigte Apache-2.0-Lizenz, eine eigene API unter platform.reflection.ai in der Public Beta, beschrieben als „kostenlos zum Einstieg", und einen technischen Sicherheitsbericht zu einem Multi-Teacher-On-Policy-Distillation-Ansatz für das Sicherheitstraining.
Die Veröffentlichung kam außerdem mit mehr als 40 bereits angebundenen Launch-Partnern: Cloud-Plattformen (AWS, Google Cloud, Microsoft Foundry, Oracle, Cloudflare, CoreWeave, Databricks), Inferenz-Marktplätze (Together AI, OpenRouter, Baseten, Fireworks, Nebius, Modal), Nvidias eigene NIM-Microservices, lokale Inferenz-Tools (Ollama, LM Studio), On-Prem- und souveräne/air-gapped-Deployment-Partner (Dell, HPE), sowie Day-Zero-Support in den Open-Source-Serving-Stacks, die Entwickler:innen tatsächlich nutzen (Transformers, vLLM, SGLang, Unsloth, Axolotl). Vercel ließ es für das Launch-Fenster kostenlos über sein AI Gateway laufen. Das ist eine wirklich breite Vertriebsoffensive für eine zwei Wochen alte Firmen-Ankündigung, und es ist der mit Abstand wichtigste Grund, die Veröffentlichung vom 16. Oktober und nicht den Teaser vom 5. Oktober als das eigentliche Launch-Datum zu behandeln, wenn man dieses Modell anderswo zitiert.
Wie es abschneidet, unabhängig und nach Reflections eigener Tabelle
Artificial Analysis, das jedes Modell durch denselben standardisierten Intelligence Index laufen lässt statt den selbst berichteten Wert eines Anbieters zu übernehmen, setzt Beam bei 30 an, gegenüber einem Kategorie-Median von 19, was Rang 19 von 120 erfassten Modellen bedeutet. Das ist ein solides, überdurchschnittliches Ergebnis. Es ist außerdem bemerkenswert schnell (227,9 Output-Tokens pro Sekunde, Platz 2 von 77 gemessenen Modellen) und relativ knapp in der Formulierung (79 Millionen Tokens, um den gesamten Index zu durchlaufen, gegenüber einem Median von 130 Millionen Tokens), was die Kosten pro Aufgabe trotz des Preises pro Token (0,70 $ Input, 2,10 $ Output pro Million Tokens), den Artificial Analysis selbst im Feldvergleich als „etwas teuer" einstuft, bei 0,57 $ hält.
Benchmark (Reflection's own table,      Beam    GLM-5.2   Kimi K3   Qwen 3.8   DeepSeek
updated 8 Oct 2026)                                                    Max       V4.1 Flash
-----------------------------------------------------------------------------------------
SWE-Bench Pro v1                        65.5     62.1       NR       67.7        NR
Terminal-Bench v2.1                     80.1     81.0      88.3      86.6       90.6
DeepSWE v1.1                            44.4     44.0      68.0      51.0       74.2
GPQA Diamond                            90.5     91.2      93.5      92.6       90.9
tau3 banking (agentic tool use)         38.0     37.1      37.1      55.2         NR
BrowseComp                              77.4       NR      91.2        NR         NR
HLE, no tools                           36.2     40.5      46.9      43.6       39.1

Figures are Reflection AI's own published comparison table. NR means
Reflection didn't report that model on that benchmark.
SWE-bench Verified (Beam: 80.9) is omitted here because Reflection's table
only compares it against two other models on that specific benchmark, not
this set.
Diese Tabelle sollte man so lesen, wie Reflection sie selbst rahmt, denn das Unternehmen ist offen darüber, wo Beam verliert. Die Kernaussage ist, dass Beam bei fortgeschrittenem Reasoning etwa auf Augenhöhe mit Z.ais GLM-5.2 liegt, bei drei- bis viermal weniger Inferenz-Rechenaufwand, eine Zahl, die Reflection ausdrücklich als Schätzung bezeichnet (berechnet als 2 × aktive Parameter × mittlere Anzahl generierter Tokens, unter Verwendung von Drittanbieter-Token-Zahlen), nicht als gemessenen Dollarbetrag. Der Vergleich erfolgt außerdem gegen GLM-5.2, nicht gegen Z.ais neueres GLM-5.3, das in fast jeder Zeile der obigen Tabelle höher punktet als Beam. Und Reflection sagt direkt, ohne Einschränkung, dass Moonshots Kimi K3 bei der reinen Leistungsfähigkeit vorne liegt: Kimi K3 ist ein nativ multimodales Modell mit 2,8 Billionen Parametern und einem Artificial-Analysis-Intelligence-Index von rund 57, in etwa auf Höhe von Claude Opus 5.5 und deutlich vor Beams 30. Beams Verkaufsargument sind Effizienz und US-Herkunft, nicht der direkte Sieg bei der Leistungsfähigkeit.
Eine Zahl, die man im Kopf haben sollte, bevor man Beam bei irgendetwas Faktischem vertraut: Auf Artificial Analysis' AA-Omniscience-Benchmark, der misst, wie oft ein Modell selbstbewusst etwas Falsches behauptet, liegt Beams Halluzinationsrate bei rund 47 %, gegenüber einer Korrektquote von rund 33 % im selben Test. Das ist ein deutlich schlechteres Verhältnis, als man es sich für Recherche- oder zitierintensive Arbeit wünscht, und ein gutes Argument dafür, Beam mit Retrieval oder Source-Grounding zu kombinieren (etwas, das Gemini Notebook nativ macht), statt seinen unbegleiteten Faktenaussagen zu vertrauen.
Ist Beam wirklich das führende „westliche" Open-Weight-Modell? Nicht ganz
Mehrere Artikel aus der Launch-Woche stellten Beam als die führende, in den USA gebaute Antwort auf chinesische Open-Weight-Labore dar, ohne zu prüfen, was sonst noch im selben Zeitraum erschienen war. Auf Artificial Analysis' eigenem Intelligence Index erreicht Metas Muse Spark Open, ein Open-Weight-Modell mit 816 Milliarden Parametern (42 Milliarden aktiv), veröffentlicht unter Metas eigener Muse Model License, 39 Punkte, vor Beams 30. Das macht Beam nach diesem Maßstab zum zweitplatzierten Open-Weight-Modell aus den USA, nicht zum ersten. (Muse Spark Open ist ein anderes Modell als Metas Muse Wonder, ein geschlossenes Frontier-Modell, das Meta im selben Monat veröffentlichte; die beiden werden wegen des gemeinsamen „Muse"-Brandings leicht verwechselt, aber das eine ist Open-Weight und das andere nicht.) Das ist nur eine kleine Korrektur, aber die Art von Detail, die man richtig haben sollte, wenn man ein Modell gezielt wegen seiner Herkunft wählt und nicht wegen seiner Benchmark-Werte.
Kann man das selbst betreiben?
Nicht auf einem Laptop, und nicht auf einer einzelnen Consumer-GPU. Weil Beam ein Mixture-of-Experts-Modell ist, aktivieren sich pro Token nur 23 der 501 Milliarden Parameter, was den Inferenz-Rechenaufwand niedrig hält, aber alle 501 Milliarden Parameter müssen trotzdem im Speicher liegen, egal welche Experten für eine konkrete Anfrage aktiv sind. Bei voller BF16-Präzision sind das rund 1 TB Gewichts-Speicher; FP8 oder INT8 drückt das auf etwa 500-600 GB; die aggressivste NVFP4/INT4-Quantisierung kommt auf irgendwo um die 250-360 GB. Die praktische Untergrenze für Self-Hosting ist ein einzelner 8xH200-Knoten (141 GB pro GPU) unter FP8, oder zwei 8xH100-Knoten (80 GB), aufgeteilt mit Tensor- und Pipeline-Parallelismus. Das ist ein Modell für Rechenzentrums-Klasse, kein Hobbyisten-Modell, gut zu wissen, bevor man nach einem Weg sucht, es zu Hause zu betreiben.
Wer es nur nutzen statt hosten möchte: Die Preise unterscheiden sich spürbar je Anbieter. OpenRouter listet es mit rund 0,25 $ Input / 1,00 $ Output pro Million Tokens, während Artificial Analysis' eigener gemessener Median über alle Anbieter näher bei 0,70 $/2,10 $ liegt. Jede einzelne Zahl hier sollte man als Momentaufnahme behandeln, nicht als festen Preis, und den aktuellen Satz beim tatsächlich genutzten Anbieter prüfen, da Beam mit mehr als 40 Hosting-Partnern gestartet ist und die es nicht alle gleich bepreisen.
Was Entwickler:innen tatsächlich sagen
Der Hacker-News-Thread zu Beams ursprünglicher Ankündigung (556 Punkte, 173 Kommentare) ist ein nützlicher Stimmungstest, und er lief praktisch komplett vor der Veröffentlichung am 16. Oktober. Die meistgevotete inhaltliche Kritik verglich Beam direkt mit DeepSeeks V4.1 Flash: Ein Kommentator schrieb, Beam „wirkt größer als DeepSeek v4.1 Flash, teurer im Betrieb und schlechter bei jeder gemessenen Metrik", eine Behauptung, die die obige Benchmark-Tabelle speziell bei agentischen und Coding-Aufgaben teilweise bestätigt. Ein wiederkehrendes Thema, wenig überraschend bei einer Ankündigung ohne angehängte Gewichte, waren Varianten von „Reden ist billig, zeig mir die Gewichte", zusammen mit gezielter Kritik daran, dass ein Unternehmen sich nicht als offen vermarkten sollte, während es die eigentliche Veröffentlichung zurückhält. Andere Threads behandelten wirklich nützliches praktisches Terrain: Schätzungen, dass Beam lokal bei 4-Bit-Quantisierung so etwas wie zwei 128-GB-Unified-Memory-Maschinen bräuchte, und Hinweise, dass Beam keine Vision-Unterstützung hat, wo manche Konkurrenten das anbieten. Ein separater, wiederkehrender Diskussionsstrang war Skepsis gegenüber dem Framing „westliche Alternative zu chinesischen Laboren" selbst, wobei manche Kommentatoren argumentierten, die nationale Herkunft leiste im Pitch mehr Arbeit als die Benchmark-Zahlen.
Auf r/LocalLLaMA entfernten Moderatoren den ursprünglichen Ankündigungsthread vom 5. Oktober Berichten zufolge, weil er gegen die No-Vaporware-Regel des Subreddits verstieß, da noch keine Gewichte öffentlich waren. Nachdem Benchmarks und später die tatsächlichen Gewichte eintrafen, war dort die gängigere Einschätzung, dass Beam in etwa auf Höhe von GLM-5.2 liegt, wobei der Hauptreiz für ernsthafte Nutzer:innen Datensouveränität und nicht-chinesische Herkunft für Deployments ist, bei denen das konkret zählt, statt dass Beam die stärkste verfügbare Option bei reiner Leistungsfähigkeit wäre.
Solltest du es nutzen
- Du brauchst ein nicht-chinesisches, wirklich offenes Modell für ein souveränitätssensibles Deployment (Behörde, regulierte Branche, Air-Gap-Umgebung): eine starke Passung und wohl Beams klarster Unterscheidungspunkt, mit Dell und HPE bereits als On-Prem-Partnern.
- Du wählst ein Open-Weight-Modell rein nach Leistungsfähigkeit: eine schwächere Passung. Kimi K3 liegt laut Reflections eigenen veröffentlichten Zahlen bei reinem Reasoning und agentischen Benchmarks vorne, und Metas Muse Spark Open punktet auf Artificial Analysis' Intelligence Index höher.
- Du willst auf eigener Hardware selbst hosten: nur mit Rechenzentrums-GPUs realistisch (mindestens etwa ein einzelner 8xH200-Knoten); auf Consumer-Hardware keine Option.
- Du brauchst faktische Zuverlässigkeit für Recherche- oder zitierintensive Arbeit: allein eine schwache Passung. Die Halluzinationsrate von rund 47 % auf AA-Omniscience ist ein echtes Risiko; kombiniere es mit Retrieval oder Source-Grounding, statt unbegleiteten Antworten zu vertrauen.
- Du willst schnelle, relativ günstige agentische Coding-Läufe und kannst damit leben, dass es hinter der absoluten Spitze zurückbleibt: eine vernünftige Passung, angesichts seiner Ausgabegeschwindigkeit auf Platz 2 von 77 und unterdurchschnittlicher Kosten pro Intelligence-Index-Aufgabe.
Häufig gestellte Fragen
Ist Reflection AIs Beam wirklich Open Source?
Es ist Open-Weight, nicht vollständig Open-Source. Die Gewichte, der Tokenizer und eine Referenzimplementierung sind unter Apache 2.0 öffentlich, bestätigt vom Unternehmen bei der Veröffentlichung am 16. Oktober 2026. Die Trainingsdaten und der vollständige Trainingscode werden nicht veröffentlicht, die übliche Unterscheidung zwischen „Open-Weight" und „Open-Source" bei großen Modellen.
Kann ich Beam auf meinem eigenen Computer betreiben?
Nicht auf einer Consumer-GPU oder einem Laptop. Selbst bei der aggressivsten Quantisierung (NVFP4/INT4) braucht das vollständige Modell rund 250-360 GB Speicher, weil alle 501 Milliarden Parameter im Speicher bleiben müssen, egal wie viele pro Token aktivieren. Das realistische Minimum ist ein einzelner 8xH200-Rechenzentrums-Knoten.
Ist Beam besser als DeepSeek, Qwen oder Kimi K3?
Bei reiner Leistungsfähigkeit nicht. In Reflections eigener veröffentlichter Benchmark-Tabelle schlagen Kimi K3 und DeepSeek V4.1 Flash Beam bei den meisten agentischen und Coding-Benchmarks (Terminal-Bench, DeepSWE, BrowseComp). Beams Verkaufsargument sind Inferenz-Effizienz und US-/nicht-chinesische Herkunft, nicht der direkte Sieg bei den Punktzahlen.
Ist das dasselbe „Reflection", das 2024 den Fake-Benchmark-Skandal hatte?
Nein. Das war ein anderes Unternehmen, Matt Shumers HyperWrite, dessen gehostetes „Reflection 70B"-Modell sich als Weiterleitung von Anfragen an Claude herausstellte, statt das behauptete Modell tatsächlich laufen zu lassen. Reflection AI, 2024 gegründet von den ehemaligen Google-DeepMind-Forschern Misha Laskin und Ioannis Antonoglou und finanziert von Nvidia, Sequoia und Lightspeed, ist ein unabhängiges, unverwandtes Unternehmen.
Wann wurden Beams Gewichte tatsächlich veröffentlicht?
Reflection kündigte Beam am 5. Oktober 2026 an, mit frühem Zugang nur über eine Warteliste. Die vollständigen offenen Gewichte, der technische Bericht und der Sicherheitsbericht sowie die Partner-Integrationen gingen am 16. Oktober 2026 live, fast zwei Wochen später, eine Lücke, die ein Großteil der Berichterstattung aus der Launch-Woche zeitlich nicht erfasst.
Ist Beam das beste außerhalb Chinas gebaute Open-Weight-Modell?
Nach Artificial Analysis' eigenem Intelligence Index nicht. Metas Muse Spark Open, ein Open-Weight-Modell mit 816 Milliarden Parametern, veröffentlicht unter Metas eigener Lizenz, erreicht auf demselben unabhängigen Benchmark 39 Punkte gegenüber Beams 30, womit Beam das zweitplatzierte Open-Weight-Modell aus den USA ist, nicht das erste.
Exportiere dein NotebookLM mit einem Klick
Kostenlose Chrome-Erweiterung. PDF, Word und Markdown. Auf deinem Gerät gerendert — nichts wird hochgeladen.