Beam de Reflection AI, expliqué : le modèle à poids ouverts annoncé trop tôt et livré deux semaines plus tard
Reflection AI, une startup soutenue par Nvidia et Sequoia et fondée par deux anciens chercheurs de Google DeepMind, a annoncé son premier modèle à poids ouverts, Beam, le 5 octobre 2026, avec seulement une liste d'attente à montrer. La majeure partie des articles encore en ligne a été écrite pendant cet intervalle, quand « poids ouverts » signifiait une promesse plutôt qu'un téléchargement. Reflection a réellement livré les poids, un rapport de sécurité et un accès API via plus de 40 partenaires le 16 octobre. Voici ce qu'est Beam, comment il se positionne face aux modèles ouverts chinois auxquels il est comparé, et si l'écart entre l'annonce et la sortie réelle change la confiance à accorder au reste des affirmations.
Beam est un modèle à mélange d'experts épars de 501 milliards de paramètres (23 milliards actifs par token) de Reflection AI, annoncé le 5 octobre 2026 et livré en poids ouverts sous licence Apache 2.0 le 16 octobre. Les poids sont disponibles sur Hugging Face en BF16, FP8 et NVFP4, avec une API propre en bêta publique et plus de 40 partenaires de lancement dont AWS, Google Cloud, Oracle, Cloudflare et OpenRouter.
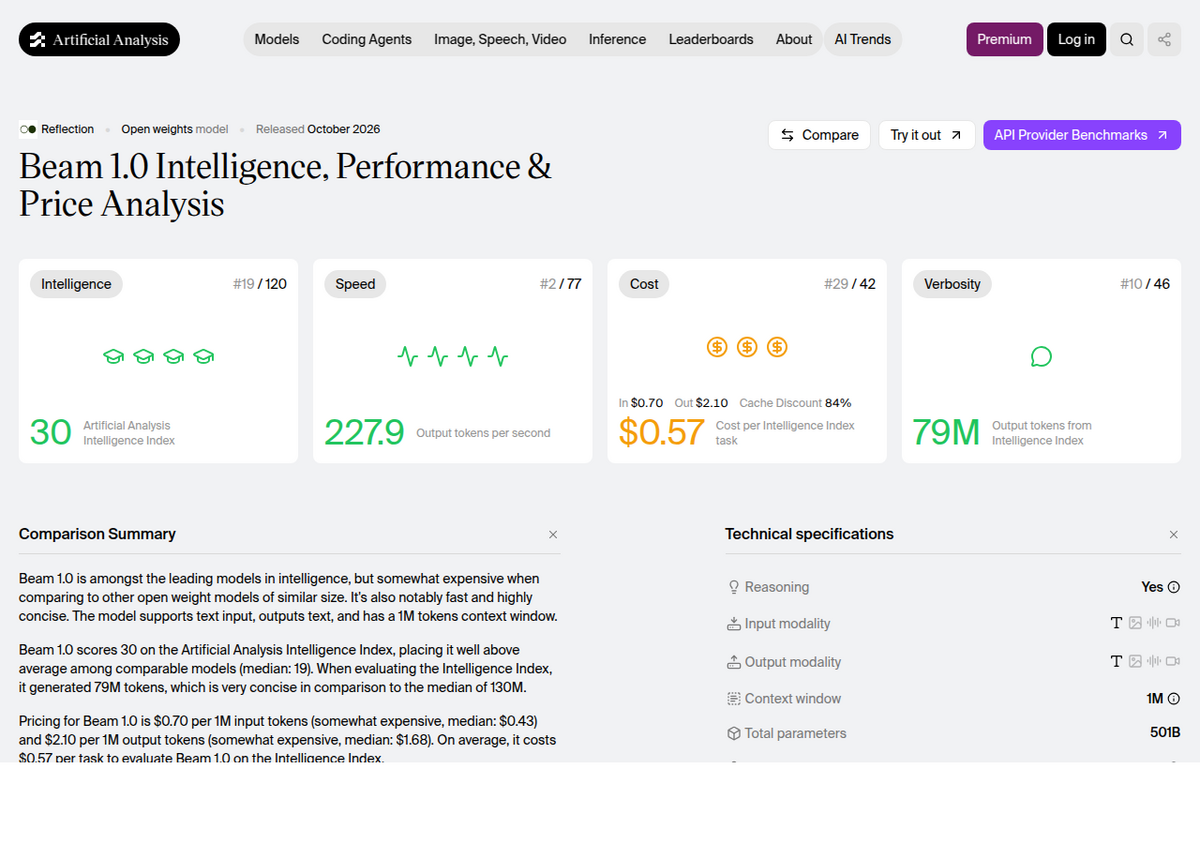
De façon indépendante, il obtient un score de 30 sur l'Intelligence Index d'Artificial Analysis (médiane pour les modèles comparables : 19), classé 19ᵉ sur 120 modèles suivis au moment de la rédaction. Il est rapide (227,9 tokens de sortie par seconde, 2ᵉ sur 77 modèles mesurés) et relativement peu coûteux à l'exécution par tâche, mais ce n'est pas le modèle à poids ouverts le plus performant disponible : Kimi K3 de Moonshot le devance sur la plupart des benchmarks de raisonnement et d'agent, et le propre tableau publié par Reflection le reconnaît lui-même.
Il faut du matériel sérieux. En BF16, les poids seuls pèsent environ 1 To ; même en FP8, il faut quelque chose comme un seul nœud 8xH200. Il n'existe aucune façon réaliste de le faire tourner sur un ordinateur portable ou un seul GPU grand public.
Il n'a aucun lien avec la controverse « Reflection 70B » de 2024, où le modèle hébergé « 70B » d'une autre entreprise s'est avéré router secrètement les requêtes vers Claude. Reflection AI (2024, fondée par Misha Laskin et Ioannis Antonoglou) est une entreprise sans rapport, une confusion qui revient assez souvent dans les forums de développeurs pour valoir la peine d'être clarifiée directement.
Ce qu'est vraiment Beam
Beam est un modèle à mélange d'experts épars : 501 milliards de paramètres au total, mais seuls 23 milliards d'entre eux s'activent pour un token donné, répartis sur 52 couches avec une attention locale et globale entrelacée et un équilibrage de charge entre experts sans perte auxiliaire. Il est uniquement textuel, en entrée comme en sortie : pas de génération d'images, et il ne peut raisonner sur du contenu visuel que si ce contenu est d'abord converti en texte par autre chose. La propre annonce de Reflection le présente comme visant spécifiquement le code, le raisonnement et le travail agentique, pas la discussion générale.
Les données de pré-entraînement sont la partie à laquelle Reflection consacre le plus de mots. L'entreprise dit être partie du crawl internet brut habituel et en avoir écarté environ 95 % par curation, pour aboutir à environ 1 800 milliards de tokens de ce qu'elle appelle du contenu réellement de haute qualité que des filtres classiques auraient manqué, intégrés dans un pré-entraînement total de 23 800 milliards de tokens. La fenêtre de contexte est de 1 million de tokens, mais ce chiffre est atteint grâce à une étape d'extension en milieu d'entraînement ; la phase d'apprentissage par renforcement qui suit est elle-même plafonnée à 256 000 tokens, une distinction à connaître si vous évaluez Beam spécifiquement pour des tâches agentiques à très long contexte plutôt que pour de simples documents longs.
L'entraînement, en chiffres que la plupart des annonces de modèles ne publient pas
Reflection est inhabituellement précis sur la façon dont Beam a été construit, et les deux phases d'entraînement ont utilisé du matériel différent. Le pré-entraînement a tourné sur 6 144 GPU Nvidia GB300 NVL72 pendant moins de quatre semaines, atteignant 92,3 % de goodput (la part du temps GPU produisant réellement une progression d'entraînement utile) en fin de parcours, avec 9 retours en arrière semi-automatiques déclenchés par des pics de gradient ou des corruptions de données silencieuses suspectées. L'apprentissage par renforcement a ensuite tourné séparément sur 10 500 GPU GB300 pendant quatre semaines, générant plus de 100 millions de rollouts, dont environ 80 millions dirigés spécifiquement vers un sous-composant « expert du raisonnement ». Au pic, l'entraînement RL a soutenu environ 110 000 rollouts concurrents en moyenne et jusqu'à 170 000 sandboxes concurrents, pour 1,3 milliard d'invocations de sandbox au total contre environ 1 million d'environnements RL majoritairement synthétiques. Les mises à jour de poids auraient atteint la flotte d'inférence en production en une médiane d'environ 12 secondes, et l'entraînement a absorbé 71 incidents d'inférence sans interrompre l'entraînement, avec un rétablissement médian de 8 minutes chaque fois.
Ces deux chiffres de GPU, 6 144 pour le pré-entraînement et 10 500 pour le RL, apparaissent dans différents articles tiers comme s'ils se contredisaient. Ce n'est pas le cas : l'un est le cluster de pré-entraînement, l'autre le cluster d'apprentissage par renforcement, bien plus grand, qui a tourné ensuite, et les confondre est une erreur à surveiller si vous recoupez d'autres articles sur ce lancement.
Annoncé le 5 octobre, réellement sorti le 16 octobre
C'est le détail sur lequel la plupart des articles existants sur Beam sont périmés, parce qu'ils ont été écrits pendant cet intervalle. L'annonce du 5 octobre de Reflection n'ouvrait l'accès anticipé que via une liste d'attente, l'entreprise disant que les poids, un rapport technique et des outils développeurs suivraient « dans les prochaines semaines » pendant que le modèle terminait ce qu'elle décrivait comme des vérifications de sécurité finales. Onze jours plus tard, Reflection a publié un second billet, « Beam is now available », daté du 16 octobre 2026, confirmant la sortie complète : poids ouverts sur Hugging Face (formats BF16, FP8 et NVFP4, plus un modèle brouillon de décodage spéculatif séparé), une licence Apache 2.0 confirmée, une API propre sur platform.reflection.ai en bêta publique décrite comme « gratuite pour démarrer », et un rapport technique de sécurité couvrant une approche de distillation on-policy multi-enseignants pour l'entraînement à la sécurité.
La sortie est aussi arrivée avec plus de 40 partenaires de lancement déjà branchés : plateformes cloud (AWS, Google Cloud, Microsoft Foundry, Oracle, Cloudflare, CoreWeave, Databricks), places de marché d'inférence (Together AI, OpenRouter, Baseten, Fireworks, Nebius, Modal), les microservices NIM propres à Nvidia, des outils d'inférence locale (Ollama, LM Studio), des partenaires de déploiement sur site et souverain/air-gapped (Dell, HPE), et un support jour zéro dans les piles de service open source que les développeurs utilisent réellement (Transformers, vLLM, SGLang, Unsloth, Axolotl). Vercel l'a fait tourner gratuitement sur son AI Gateway pendant la fenêtre de lancement. C'est une diffusion véritablement large pour une annonce d'entreprise vieille de deux semaines, et c'est la raison principale de considérer la sortie du 16 octobre, pas le teaser du 5 octobre, comme la vraie date de lancement quand vous citez ce modèle ailleurs.
Comment il se positionne dans les benchmarks, indépendamment et selon le tableau de Reflection
Artificial Analysis, qui fait passer chaque modèle par le même Intelligence Index standardisé plutôt que de reprendre le score auto-déclaré d'un fournisseur, place Beam à 30, contre une médiane de catégorie de 19, le classant 19ᵉ sur 120 modèles suivis. C'est un résultat solide, au-dessus de la médiane. Il est aussi notablement rapide (227,9 tokens de sortie par seconde, 2ᵉ sur 77 modèles mesurés) et relativement concis (79 millions de tokens pour exécuter l'Index complet, contre une médiane de 130 millions), ce qui maintient son coût par tâche à 0,57 $ malgré une tarification par token (0,70 $ en entrée, 2,10 $ en sortie par million de tokens) que Artificial Analysis elle-même qualifie de « plutôt chère » par rapport au reste du marché.
Benchmark (Reflection's own table,      Beam    GLM-5.2   Kimi K3   Qwen 3.8   DeepSeek
updated 8 Oct 2026)                                                    Max       V4.1 Flash
-----------------------------------------------------------------------------------------
SWE-Bench Pro v1                        65.5     62.1       NR       67.7        NR
Terminal-Bench v2.1                     80.1     81.0      88.3      86.6       90.6
DeepSWE v1.1                            44.4     44.0      68.0      51.0       74.2
GPQA Diamond                            90.5     91.2      93.5      92.6       90.9
tau3 banking (agentic tool use)         38.0     37.1      37.1      55.2         NR
BrowseComp                              77.4       NR      91.2        NR         NR
HLE, no tools                           36.2     40.5      46.9      43.6       39.1

Figures are Reflection AI's own published comparison table. NR means
Reflection didn't report that model on that benchmark.
SWE-bench Verified (Beam: 80.9) is omitted here because Reflection's table
only compares it against two other models on that specific benchmark, not
this set.
Lisez ce tableau de la façon dont Reflection le présente elle-même, parce que l'entreprise est franche sur les points où Beam perd. Son affirmation phare est que Beam performe à peu près au niveau de GLM-5.2 de Z.ai en raisonnement avancé avec trois à quatre fois moins de calcul d'inférence, un chiffre que Reflection qualifie explicitement d'estimation (calculé comme 2 × paramètres actifs × tokens générés en moyenne, en utilisant des comptages de tokens tiers), pas un coût en dollars mesuré. La comparaison se fait aussi contre GLM-5.2, pas contre le GLM-5.3 plus récent de Z.ai, qui obtient un score supérieur à Beam sur presque toutes les lignes du tableau ci-dessus. Et Reflection affirme directement, sans détour, que Kimi K3 de Moonshot domine en capacité brute : Kimi K3 est un modèle nativement multimodal de 2 800 milliards de paramètres avec un Intelligence Index Artificial Analysis d'environ 57, à peu près au niveau de Claude Opus 5.5 et largement devant le 30 de Beam. L'argument de vente de Beam, c'est l'efficacité et la provenance américaine, pas la victoire frontale en capacité.
Un chiffre à signaler avant de faire confiance à Beam pour quoi que ce soit de factuel : sur le benchmark AA-Omniscience d'Artificial Analysis, qui mesure la fréquence à laquelle un modèle affirme quelque chose de faux avec assurance, le taux d'hallucination de Beam tourne autour de 47 %, contre un taux de bonnes réponses d'environ 33 % sur le même test. C'est un ratio nettement moins bon que ce qu'on voudrait pour de la recherche ou un travail riche en citations, et c'est un bon argument pour associer Beam à de la récupération ou à un ancrage sur des sources (le genre de chose que Gemini Notebook fait nativement) plutôt que de faire confiance à ses affirmations factuelles non assistées.
Beam est-il vraiment le meilleur modèle à poids ouverts « occidental » ? Pas tout à fait
Plusieurs articles de la semaine de lancement ont présenté Beam comme la réponse américaine de référence face aux laboratoires chinois à poids ouverts, sans vérifier ce qui avait été livré ailleurs pendant la même fenêtre. Sur l'Intelligence Index d'Artificial Analysis lui-même, Muse Spark Open de Meta, un modèle à poids ouverts de 816 milliards de paramètres (42 milliards actifs) publié sous la licence Muse Model propre à Meta, obtient un score de 39, devant le 30 de Beam. Cela fait de Beam le deuxième modèle à poids ouverts d'origine américaine selon cette mesure, pas le premier. (Muse Spark Open est un modèle différent de Muse Wonder de Meta, un modèle de pointe fermé que Meta a livré le même mois ; les deux sont faciles à confondre à cause de la marque « Muse » partagée, mais l'un est à poids ouverts et l'autre non.) C'est une correction mineure, mais c'est le genre de détail qui vaut la peine d'être exact si vous choisissez un modèle spécifiquement pour son origine plutôt que pour ses scores de benchmark.
Pouvez-vous réellement le faire tourner vous-même
Pas sur un ordinateur portable, et pas sur un seul GPU grand public. Parce que Beam est un modèle à mélange d'experts, seuls 23 des 501 milliards de paramètres s'activent par token, ce qui réduit le calcul d'inférence, mais les 501 milliards de paramètres doivent tous rester en mémoire, quels que soient les experts actifs pour une requête donnée. En pleine précision BF16, cela représente environ 1 To de mémoire de poids ; en FP8 ou INT8, on descend à environ 500-600 Go ; la quantification la plus agressive en NVFP4/INT4 amène à quelque chose comme 250-360 Go. Le plancher pratique pour l'auto-hébergement est un seul nœud 8xH200 (141 Go par GPU) en FP8, ou deux nœuds 8xH100 (80 Go) répartis avec du parallélisme tensoriel et de pipeline. C'est un modèle de niveau datacenter, pas un modèle de passionné, ce qui vaut la peine d'être su avant de chercher un moyen de le faire tourner chez soi.
Si vous voulez simplement l'utiliser plutôt que l'héberger, les tarifs varient sensiblement selon le fournisseur : OpenRouter l'affiche autour de 0,25 $ en entrée / 1,00 $ en sortie par million de tokens, alors que la médiane mesurée par Artificial Analysis elle-même sur l'ensemble des fournisseurs est plus proche de 0,70 $/2,10 $. Traitez n'importe quel chiffre ici comme un instantané plutôt qu'un prix fixe, vérifiez le tarif en direct chez le fournisseur que vous utilisez réellement, puisque Beam a été lancé avec plus de 40 partenaires d'hébergement qui ne le tarifent pas tous pareil.
Ce que disent réellement les développeurs
Le fil Hacker News sur l'annonce initiale de Beam (556 points, 173 commentaires) donne une bonne idée de l'ambiance, et il s'est déroulé presque entièrement avant la sortie du 16 octobre. La critique de fond la plus votée comparait Beam directement à V4.1 Flash de DeepSeek : un commentateur écrivait que Beam « semble plus gros que DeepSeek v4.1 Flash, plus cher à faire tourner, et pire sur toutes les métriques mesurées », une affirmation que le tableau de benchmark ci-dessus confirme partiellement, spécifiquement sur les tâches agentiques et de code. Un thème récurrent, sans surprise pour une annonce sans poids encore attachés, tournait autour de variantes de « les paroles sont faciles, montrez-moi les poids », aux côtés d'une critique pointue selon laquelle une entreprise ne devrait pas se présenter comme ouverte tout en verrouillant la sortie réelle. D'autres fils couvraient un terrain pratique vraiment utile : des estimations selon lesquelles faire tourner Beam localement en quantification 4 bits nécessiterait quelque chose comme deux machines à mémoire unifiée de 128 Go, et des remarques notant que Beam n'a pas de support visuel là où certains concurrents en ont. Un autre fil récurrent de la discussion portait sur le scepticisme envers le cadrage « alternative occidentale aux laboratoires chinois » lui-même, certains commentateurs estimant que l'origine nationale pesait plus dans l'argumentaire que les chiffres de benchmark.
Sur r/LocalLLaMA, les modérateurs auraient retiré le fil de l'annonce initiale du 5 octobre pour avoir violé la règle du subreddit contre le vaporware, puisqu'aucun poids n'était encore public. Une fois les benchmarks, puis les poids réels, arrivés, le cadrage le plus courant y était que Beam se situe à peu près au niveau de GLM-5.2, l'intérêt principal pour les utilisateurs sérieux étant la souveraineté des données et la provenance non chinoise pour les déploiements où cela compte spécifiquement, plutôt que Beam étant l'option disponible la plus performante en capacité pure.
Faut-il l'utiliser
- Vous avez besoin d'un modèle réellement à poids ouverts et non chinois pour un déploiement sensible en matière de souveraineté (gouvernement, entreprise réglementée, environnement air-gapped) : une bonne adéquation, sans doute le différenciateur le plus clair de Beam, avec Dell et HPE déjà en place comme partenaires sur site.
- Vous choisissez un modèle à poids ouverts uniquement sur la capacité : une adéquation plus faible. Kimi K3 domine en raisonnement brut et en benchmarks agentiques selon les propres chiffres publiés par Reflection, et Muse Spark Open de Meta obtient un score supérieur sur l'Intelligence Index d'Artificial Analysis.
- Vous voulez l'auto-héberger sur votre propre matériel : réaliste uniquement avec des GPU de classe datacenter (minimum environ un seul nœud 8xH200) ; pas une option sur du matériel grand public.
- Vous avez besoin de fiabilité factuelle pour de la recherche ou un travail riche en citations : une adéquation faible à lui seul. Le taux d'hallucination d'environ 47 % sur AA-Omniscience est un vrai handicap ; associez-le à de la récupération ou à un ancrage sur des sources plutôt que de faire confiance à ses réponses non assistées.
- Vous voulez des exécutions agentiques de code rapides et relativement bon marché, et pouvez tolérer qu'il reste derrière le tout premier niveau : une adéquation raisonnable, étant donné sa vitesse de sortie 2ᵉ sur 77 et son coût inférieur à la médiane par tâche Intelligence Index.
Questions fréquentes
Le Beam de Reflection AI est-il vraiment open source ?
Il est à poids ouverts, pas entièrement open source. Les poids, le tokenizer et une implémentation de référence sont publics sous licence Apache 2.0, confirmée par l'entreprise lors de la sortie du 16 octobre 2026. Les données d'entraînement et le code d'entraînement complet ne sont pas publiés, ce qui est la distinction habituelle entre « poids ouverts » et « open source » pour les grands modèles.
Puis-je faire tourner Beam sur mon propre ordinateur ?
Pas sur un GPU grand public ni un ordinateur portable. Même à la quantification la plus agressive (NVFP4/INT4), le modèle complet nécessite environ 250-360 Go de mémoire, car les 501 milliards de paramètres doivent tous rester résidents, quel que soit le nombre qui s'active par token. Le minimum réaliste est un seul nœud datacenter 8xH200.
Beam est-il meilleur que DeepSeek, Qwen ou Kimi K3 ?
Pas en capacité brute. Le propre tableau de benchmark publié par Reflection montre Kimi K3 et DeepSeek V4.1 Flash devançant Beam sur la plupart des benchmarks agentiques et de code (Terminal-Bench, DeepSWE, BrowseComp). L'argument de vente de Beam, c'est l'efficacité d'inférence et la provenance américaine/non chinoise, pas la victoire frontale sur les scores.
Est-ce le même « Reflection » que celui du scandale des faux benchmarks en 2024 ?
Non. C'était une entreprise différente, HyperWrite de Matt Shumer, dont le modèle hébergé « Reflection 70B » s'est avéré router les requêtes vers Claude plutôt que de faire tourner le modèle annoncé. Reflection AI, fondée en 2024 par les anciens chercheurs de Google DeepMind Misha Laskin et Ioannis Antonoglou et soutenue par Nvidia, Sequoia et Lightspeed, est une entreprise sans rapport.
Quand les poids de Beam ont-ils réellement été publiés ?
Reflection a annoncé Beam le 5 octobre 2026 avec un accès anticipé via liste d'attente uniquement. Les poids ouverts complets, les rapports techniques et de sécurité, et les intégrations partenaires sont devenus disponibles le 16 octobre 2026, presque deux semaines plus tard, un écart que la plupart des articles de la semaine de lancement précèdent.
Beam est-il le meilleur modèle à poids ouverts fabriqué hors de Chine ?
Pas selon l'Intelligence Index d'Artificial Analysis lui-même. Muse Spark Open de Meta, un modèle à poids ouverts de 816 milliards de paramètres publié sous la licence propre à Meta, obtient un score de 39 contre le 30 de Beam sur ce même benchmark indépendant, faisant de Beam le deuxième modèle à poids ouverts d'origine américaine plutôt que le premier.
Exportez votre NotebookLM en un clic
Extension Chrome gratuite. PDF, Word et Markdown. Généré sur votre machine — rien n'est envoyé en ligne.