O Beam da Reflection AI, explicado: o modelo de peso aberto que foi anunciado antes e lançado duas semanas depois
A Reflection AI, uma startup apoiada pela Nvidia e pela Sequoia e fundada por dois ex-pesquisadores do Google DeepMind, anunciou seu primeiro modelo de peso aberto, o Beam, em 5 de outubro de 2026, com apenas uma lista de espera para mostrar. A maior parte da cobertura que ainda está online foi escrita nesse intervalo, quando "peso aberto" significava uma promessa, não um download. A Reflection de fato lançou os pesos, um relatório de segurança e acesso via API com mais de 40 parceiros em 16 de outubro. Veja aqui o que é o Beam, como ele se compara em benchmarks aos modelos abertos chineses contra os quais é posicionado, e se o intervalo entre o anúncio e o lançamento muda o quanto confiar no resto das alegações.
O Beam é um modelo esparso de mistura de especialistas (mixture-of-experts) com 501 bilhões de parâmetros (23 bilhões ativos por token) da Reflection AI, anunciado em 5 de outubro de 2026 e lançado como pesos abertos sob a licença Apache 2.0 em 16 de outubro. Os pesos já estão no Hugging Face em BF16, FP8 e NVFP4, com uma API própria em beta público e mais de 40 parceiros de lançamento, incluindo AWS, Google Cloud, Oracle, Cloudflare e OpenRouter.
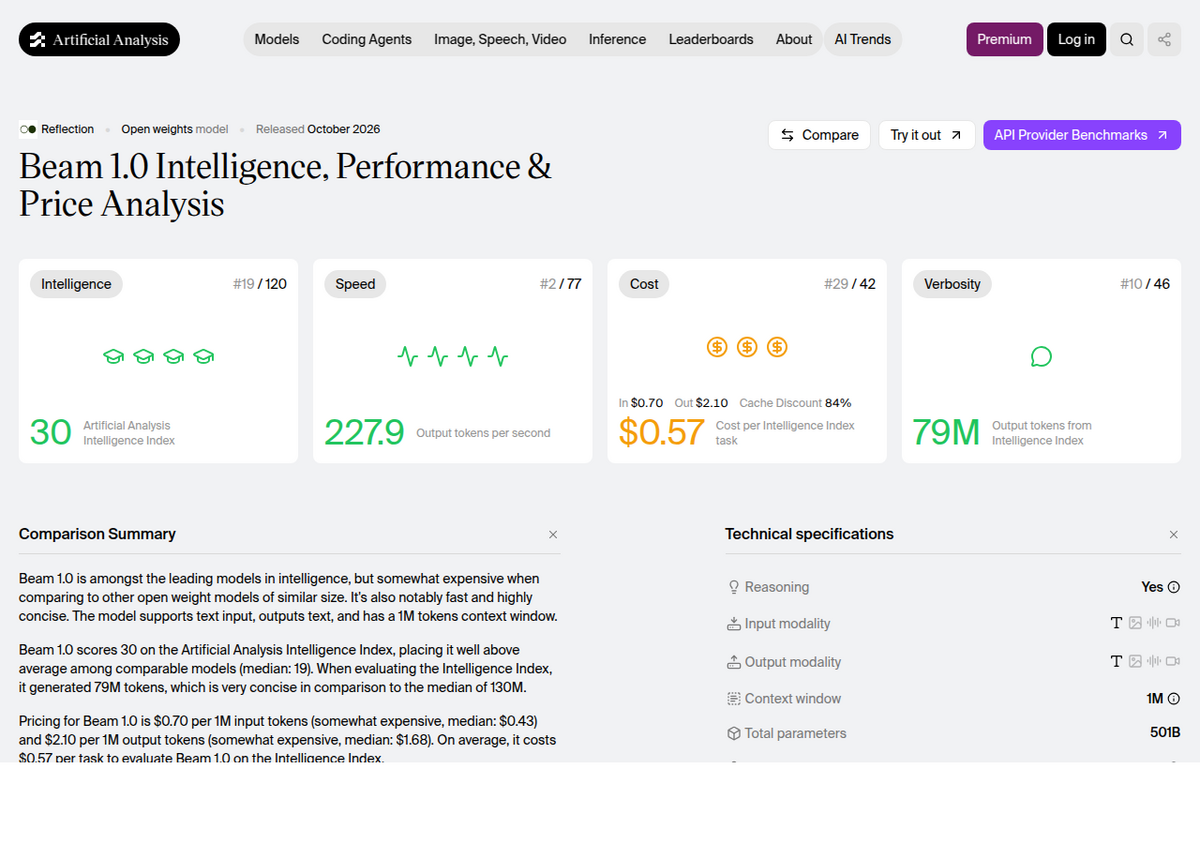
De forma independente, ele marca 30 pontos no Intelligence Index da Artificial Analysis (mediana para modelos comparáveis: 19), na 19ª posição entre 120 modelos acompanhados no momento desta publicação. É rápido (227,9 tokens de saída por segundo, 2º lugar entre 77 modelos medidos) e relativamente barato de rodar por tarefa, mas não é o modelo de peso aberto mais forte disponível: o Kimi K3 da Moonshot vence na maioria dos benchmarks de raciocínio e agênticos, e a própria tabela publicada pela Reflection admite isso.
Ele exige hardware pesado. Em BF16, só os pesos já ocupam cerca de 1TB; mesmo em FP8 você precisa de algo como um único nó 8xH200. Não existe forma realista de rodar isso num laptop ou numa única GPU de consumidor.
Ele não tem relação com a polêmica do "Reflection 70B" de 2024, em que o modelo hospedado "70B" de uma empresa diferente acabou se revelando como algo que roteava secretamente as solicitações para o Claude. A Reflection AI (2024, fundada por Misha Laskin e Ioannis Antonoglou) é uma empresa sem relação alguma com aquela, uma confusão que aparece com frequência suficiente em fóruns de desenvolvedores para merecer ser esclarecida diretamente.
O que é, de fato, o Beam
O Beam é um modelo esparso de mistura de especialistas: 501 bilhões de parâmetros totais, mas apenas 23 bilhões deles ativam para qualquer token dado, distribuídos em 52 camadas com atenção local e global intercaladas e balanceamento de carga entre especialistas sem perda auxiliar (aux-loss-free). Ele é só texto, tanto na entrada quanto na saída: sem geração de imagem, e só consegue raciocinar sobre conteúdo visual se esse conteúdo for primeiro convertido em texto por outra ferramenta. O próprio anúncio da Reflection o descreve como voltado diretamente para codificação, raciocínio e trabalho agêntico, não para chat geral.
Os dados de pré-treinamento são a parte em que a Reflection gasta mais palavras. A empresa diz que partiu do rastreamento bruto comum da internet e descartou cerca de 95% dele através de curadoria, chegando a cerca de 1,8 trilhão de tokens do que chama de material genuinamente de alta qualidade que filtros convencionais teriam deixado passar, incorporados a uma execução total de pré-treinamento de 23,8 trilhões de tokens. A janela de contexto é de 1 milhão de tokens, mas esse número é alcançado por uma etapa de extensão no meio do treinamento; a fase de aprendizado por reforço que vem depois é, ela mesma, limitada a 256.000 tokens, uma distinção que vale conhecer se você está avaliando o Beam especificamente para tarefas agênticas de contexto muito longo, e não apenas documentos únicos longos.
A execução de treinamento, em números que a maioria dos anúncios de modelo não publica
A Reflection é incomumente específica sobre como o Beam foi construído, e as duas fases de treinamento usaram hardware diferente. O pré-treinamento rodou em 6.144 GPUs Nvidia GB300 NVL72 por menos de quatro semanas, atingindo 92,3% de goodput (a fração do tempo de GPU que de fato produz progresso útil de treinamento) perto do final da execução, com 9 retrocessos semiautomáticos disparados por picos de gradiente ou suspeita de corrupção silenciosa de dados. O aprendizado por reforço então rodou separadamente em 10.500 GPUs GB300 por quatro semanas, gerando mais de 100 milhões de rollouts, cerca de 80 milhões deles direcionados especificamente a um subcomponente "especialista em raciocínio". No pico, a execução de RL sustentou em média cerca de 110.000 rollouts simultâneos e até 170.000 sandboxes simultâneos, 1,3 bilhão de invocações totais de sandbox contra aproximadamente 1 milhão de ambientes de RL majoritariamente sintéticos. As atualizações de pesos supostamente chegavam à frota de inferência em produção numa mediana de cerca de 12 segundos, e a execução absorveu 71 incidentes de inferência sem interromper o treinamento, recuperando-se numa mediana de 8 minutos cada vez.
Esses dois números de GPUs, 6.144 para o pré-treinamento e 10.500 para o RL, aparecem em diferentes artigos de terceiros como se se contradissessem. Não é o caso: um é o cluster de pré-treinamento, o outro é o cluster de aprendizado por reforço, muito maior, que rodou depois, e confundir os dois é um erro que vale a pena observar se você estiver conferindo outras coberturas desse lançamento.
Anunciado em 5 de outubro, lançado de fato em 16 de outubro
Esse é o detalhe em que a maior parte da cobertura existente sobre o Beam fica desatualizada, porque boa parte dela foi escrita nesse intervalo. O anúncio de 5 de outubro da Reflection abriu o acesso antecipado só por lista de espera, com a empresa dizendo que os pesos, um relatório técnico e ferramentas para desenvolvedores viriam "nas próximas semanas", enquanto o modelo terminava o que ela descreveu como checagens finais de segurança. Onze dias depois, a Reflection publicou um segundo post, "Beam is now available", datado de 16 de outubro de 2026, confirmando o lançamento completo: pesos abertos no Hugging Face (formatos BF16, FP8 e NVFP4, mais um modelo rascunho separado para decodificação especulativa), uma licença Apache 2.0 confirmada, uma API própria em platform.reflection.ai em beta público descrita como "gratuita para começar", e um relatório técnico de segurança cobrindo uma abordagem de destilação on-policy com múltiplos professores para o treinamento de segurança.
O lançamento também chegou com mais de 40 parceiros de lançamento já configurados: plataformas de nuvem (AWS, Google Cloud, Microsoft Foundry, Oracle, Cloudflare, CoreWeave, Databricks), marketplaces de inferência (Together AI, OpenRouter, Baseten, Fireworks, Nebius, Modal), os próprios microsserviços NIM da Nvidia, ferramentas de inferência local (Ollama, LM Studio), parceiros de implantação on-premise e soberana/isolada (Dell, HPE), e suporte desde o dia zero nos stacks de serviço de código aberto que os desenvolvedores de fato usam (Transformers, vLLM, SGLang, Unsloth, Axolotl). A Vercel o rodou de graça no seu AI Gateway durante a janela de lançamento. Esse é um esforço de distribuição genuinamente amplo para um anúncio de empresa com apenas duas semanas, e é o maior motivo para tratar o lançamento de 16 de outubro, não o teaser de 5 de outubro, como a data real de lançamento ao citar esse modelo em outro lugar.
Como ele se sai em benchmarks, de forma independente e pela própria tabela da Reflection
A Artificial Analysis, que roda todo modelo pelo mesmo Intelligence Index padronizado em vez de usar a pontuação autodeclarada de um fornecedor, coloca o Beam em 30, contra uma mediana de categoria de 19, na 19ª posição entre 120 modelos acompanhados. É um resultado sólido, acima da mediana. Ele também é notavelmente rápido (227,9 tokens de saída por segundo, 2º lugar entre 77 modelos medidos) e relativamente conciso (79 milhões de tokens para rodar o Index completo, contra uma mediana de 130 milhões de tokens), o que mantém o custo por tarefa em US$ 0,57, mesmo com um preço por token (US$ 0,70 de entrada, US$ 2,10 de saída por milhão de tokens) que a própria Artificial Analysis classifica como "um pouco caro" em relação ao mercado.
Benchmark (Reflection's own table,      Beam    GLM-5.2   Kimi K3   Qwen 3.8   DeepSeek
updated 8 Oct 2026)                                                    Max       V4.1 Flash
-----------------------------------------------------------------------------------------
SWE-Bench Pro v1                        65.5     62.1       NR       67.7        NR
Terminal-Bench v2.1                     80.1     81.0      88.3      86.6       90.6
DeepSWE v1.1                            44.4     44.0      68.0      51.0       74.2
GPQA Diamond                            90.5     91.2      93.5      92.6       90.9
tau3 banking (agentic tool use)         38.0     37.1      37.1      55.2         NR
BrowseComp                              77.4       NR      91.2        NR         NR
HLE, no tools                           36.2     40.5      46.9      43.6       39.1

Figures are Reflection AI's own published comparison table. NR means
Reflection didn't report that model on that benchmark.
SWE-bench Verified (Beam: 80.9) is omitted here because Reflection's table
only compares it against two other models on that specific benchmark, not
this set.
Leia essa tabela da forma como a própria Reflection a enquadra, porque a empresa é franca sobre onde o Beam perde. A alegação central é que o Beam tem desempenho mais ou menos equivalente ao GLM-5.2 da Z.ai em raciocínio avançado, com três a quatro vezes menos computação de inferência, um número que a Reflection classifica explicitamente como uma estimativa (calculado como 2 × parâmetros ativos × média de tokens gerados, usando contagens de tokens de terceiros), não um custo em dólares medido. A comparação também é contra o GLM-5.2, não contra o GLM-5.3 mais novo da Z.ai, que marca mais do que o Beam em praticamente todas as linhas da tabela acima. E a Reflection afirma diretamente, sem ressalvas, que o Kimi K3 da Moonshot lidera em capacidade bruta: o Kimi K3 é um modelo nativamente multimodal de 2,8 trilhões de parâmetros com um Intelligence Index da Artificial Analysis em torno de 57, mais ou menos no nível do Claude Opus 5.5 e bem acima dos 30 do Beam. A proposta do Beam é eficiência e origem nos EUA, não vencer o confronto direto em capacidade.
Um número que vale destacar antes de confiar no Beam para qualquer coisa factual: no benchmark AA-Omniscience da Artificial Analysis, que mede com que frequência um modelo afirma algo falso com confiança, a taxa de alucinação do Beam fica em torno de 47%, contra uma taxa de resposta correta de cerca de 33% no mesmo teste. É uma proporção bem piorada em relação ao que se gostaria para pesquisa ou trabalho com muita citação, e é um bom argumento para combinar o Beam com recuperação ou embasamento em fontes (o tipo de coisa que o Gemini Notebook faz nativamente), em vez de confiar nas afirmações factuais dele sem apoio.
O Beam é mesmo o melhor modelo de peso aberto "ocidental"? Não exatamente
Vários artigos da semana de lançamento enquadraram o Beam como a principal resposta construída nos EUA aos laboratórios chineses de peso aberto, sem checar o que mais tinha sido lançado na mesma janela. No próprio Intelligence Index da Artificial Analysis, o Muse Spark Open da Meta, um modelo de peso aberto de 816 bilhões de parâmetros (42 bilhões ativos) lançado sob a própria Licença de Modelo Muse da Meta, marca 39, na frente dos 30 do Beam. Isso faz do Beam o segundo colocado entre os modelos de peso aberto de origem americana por essa medida, não o primeiro. (O Muse Spark Open é um modelo diferente do Muse Wonder da Meta, um modelo de fronteira fechado que a Meta lançou no mesmo mês; os dois são fáceis de confundir por compartilharem a marca "Muse", mas um é de peso aberto e o outro não.) É uma correção pequena, mas é o tipo de coisa que vale a pena acertar se você está escolhendo um modelo especificamente pela origem, e não pelas pontuações de benchmark.
É possível rodar isso você mesmo
Não num laptop, e não numa única GPU de consumidor. Como o Beam é um modelo de mistura de especialistas, apenas 23 bilhões dos seus 501 bilhões de parâmetros ativam por token, o que mantém baixa a computação de inferência, mas todos os 501 bilhões de parâmetros ainda precisam ficar na memória, independentemente de quais especialistas estão ativos para qualquer solicitação. Em precisão BF16 completa, isso é cerca de 1TB de memória de pesos; FP8 ou INT8 reduz isso para cerca de 500-600GB; a quantização mais agressiva, NVFP4/INT4, chega a algo em torno de 250-360GB. O piso prático para autohospedagem é um único nó 8xH200 (141GB por GPU) rodando FP8, ou dois nós 8xH100 (80GB) divididos com paralelismo de tensor e de pipeline. Esse é um modelo de nível datacenter, não um modelo para hobbyista, o que vale saber antes de procurar uma forma de rodá-lo em casa.
Se você só quer usar, em vez de hospedar, o preço varia bastante por provedor: a OpenRouter lista cerca de US$ 0,25 de entrada / US$ 1,00 de saída por milhão de tokens, enquanto a própria mediana medida pela Artificial Analysis entre provedores fica mais perto de US$ 0,70/US$ 2,10. Trate qualquer número isolado aqui como uma fotografia do momento, não um preço fixo, e confira a taxa em tempo real no provedor que você realmente está usando, já que o Beam foi lançado com mais de 40 parceiros de hospedagem e nem todos cobram o mesmo valor.
O que os desenvolvedores estão realmente dizendo
O tópico do Hacker News sobre o anúncio original do Beam (556 pontos, 173 comentários) é uma leitura útil do clima geral, e ele rodou quase inteiramente antes do lançamento de 16 de outubro. A crítica substantiva mais votada comparou o Beam diretamente ao V4.1 Flash da DeepSeek: um comentarista escreveu que o Beam "parece ser maior do que o DeepSeek v4.1 Flash, mais caro de rodar, e pior em toda métrica medida", uma alegação que a tabela de benchmark acima confirma parcialmente, especificamente em tarefas agênticas e de codificação. Um tema recorrente, nada surpreendente para um anúncio ainda sem pesos disponíveis, foram variações de "falar é fácil, me mostre os pesos", junto com críticas pontuais de que uma empresa não deveria se promover como aberta enquanto restringe o lançamento real. Outros tópicos cobriram terreno prático genuinamente útil: estimativas de que rodar o Beam localmente em quantização de 4 bits exigiria algo como duas máquinas de memória unificada de 128GB, e observações de que o Beam não tem suporte a visão, enquanto alguns concorrentes têm. Uma vertente separada e recorrente da discussão foi o ceticismo sobre o próprio enquadramento de "alternativa ocidental aos laboratórios chineses", com alguns comentaristas argumentando que a origem nacional pesava mais na proposta do que os próprios números de benchmark.
No r/LocalLLaMA, os moderadores teriam removido o tópico inicial do anúncio de 5 de outubro por violar a regra do subreddit contra "vaporware", já que nenhum peso ainda era público. Depois que os benchmarks e, mais tarde, os pesos de fato chegaram, o enquadramento mais comum ali foi que o Beam fica mais ou menos no mesmo nível do GLM-5.2, sendo o principal atrativo para usuários sérios a soberania de dados e a origem não chinesa, para implantações em que isso especificamente importa, e não o fato de o Beam ser a opção mais forte disponível em capacidade pura.
Você deve usar
- Você precisa de um modelo genuinamente de peso aberto e não chinês para uma implantação sensível a soberania (governo, empresa regulada, ambiente isolado): um encaixe forte, e sem dúvida o diferencial mais claro do Beam, com a Dell e a HPE já configuradas como parceiras on-premise.
- Você está escolhendo um modelo de peso aberto só pela capacidade: um encaixe mais fraco. O Kimi K3 lidera em raciocínio bruto e benchmarks agênticos pelos próprios números publicados pela Reflection, e o Muse Spark Open da Meta marca mais no Intelligence Index da Artificial Analysis.
- Você quer autohospedar no seu próprio hardware: só é realista com GPUs de nível datacenter (mínimo de cerca de um único nó 8xH200); não é uma opção em hardware de consumidor.
- Você precisa de confiabilidade factual para pesquisa ou trabalho com muita citação: um encaixe fraco por si só. A taxa de alucinação de cerca de 47% no AA-Omniscience é um risco real; combine com recuperação ou embasamento em fontes, em vez de confiar nas respostas sem apoio.
- Você quer execuções agênticas de codificação rápidas e relativamente baratas, e tolera ficar atrás do nível máximo absoluto: um encaixe razoável, dada sua velocidade de saída na 2ª posição entre 77 e seu custo abaixo da mediana por tarefa do Intelligence Index.
Perguntas frequentes
O Beam da Reflection AI é realmente open source?
É de peso aberto, não totalmente open source. Os pesos, o tokenizador e uma implementação de referência são públicos sob Apache 2.0, confirmado pela empresa no lançamento de 16 de outubro de 2026. Os dados de treinamento e o código completo de treinamento não foram liberados, que é a distinção padrão entre "peso aberto" e "código aberto" para modelos grandes.
Posso rodar o Beam no meu próprio computador?
Não numa GPU de consumidor ou num laptop. Mesmo na quantização mais agressiva (NVFP4/INT4), o modelo completo precisa de cerca de 250-360GB de memória, porque todos os 501 bilhões de parâmetros precisam ficar residentes, independentemente de quantos ativam por token. O mínimo realista é um único nó datacenter 8xH200.
O Beam é melhor do que o DeepSeek, o Qwen ou o Kimi K3?
Não em capacidade bruta. A própria tabela de benchmarks publicada pela Reflection mostra o Kimi K3 e o DeepSeek V4.1 Flash vencendo o Beam na maioria dos benchmarks agênticos e de codificação (Terminal-Bench, DeepSWE, BrowseComp). A proposta do Beam é eficiência de inferência e origem americana/não chinesa, não vencer o confronto direto nas pontuações.
É a mesma "Reflection" que teve o escândalo de benchmark falso em 2024?
Não. Aquela era uma empresa diferente, a HyperWrite de Matt Shumer, cujo modelo hospedado "Reflection 70B" acabou se revelando algo que roteava as solicitações para o Claude, em vez de rodar o modelo alegado. A Reflection AI, fundada em 2024 pelos ex-pesquisadores do Google DeepMind Misha Laskin e Ioannis Antonoglou e apoiada por Nvidia, Sequoia e Lightspeed, é uma empresa sem relação alguma com aquela.
Quando os pesos do Beam foram realmente lançados?
A Reflection anunciou o Beam em 5 de outubro de 2026 com acesso antecipado só por lista de espera. Os pesos abertos completos, os relatórios técnico e de segurança, e as integrações com parceiros entraram no ar em 16 de outubro de 2026, quase duas semanas depois, um intervalo anterior a boa parte da cobertura da semana de lançamento.
O Beam é o melhor modelo de peso aberto feito fora da China?
Não pelo próprio Intelligence Index da Artificial Analysis. O Muse Spark Open da Meta, um modelo de peso aberto de 816 bilhões de parâmetros lançado sob a própria licença da Meta, marca 39 contra os 30 do Beam no mesmo benchmark independente, fazendo do Beam o segundo colocado entre os modelos de peso aberto de origem americana, não o primeiro.
Exporte seu NotebookLM em um clique
Extensão gratuita do Chrome. PDF, Word e Markdown. Renderizado na sua máquina — nada é enviado para a nuvem.