Mistral Large 4, expliqué : un modèle à mille milliards de paramètres, et des specs sur lesquelles les propres pages de Mistral ne s'accordent pas
Mistral AI a lancé Mistral Large 4 en préversion publique le 6 octobre 2026, surnommé en interne « Le Chonk » en référence à un mème sur un modèle fictif surdimensionné devenu viral quelques mois plus tôt. C'est une avancée réellement importante pour Mistral, mais aussi un lancement où la documentation, le billet de blog et les dossiers légaux de l'entreprise citent des nombres de paramètres et des tailles de fenêtre de contexte différents pour le même modèle. Voici ce qui est réellement confirmé, où se situe la vraie ambiguïté, et comment il se classe de façon indépendante face à la concurrence de pointe.
Mistral Large 4 est sorti en préversion publique le 6 octobre 2026, un modèle Mixture-of-Experts doté de 52 milliards de paramètres actifs, un chiffre sur lequel le blog et la documentation technique de Mistral s'accordent désormais. C'est le nombre total de paramètres qui reste contesté au sein même des documents de Mistral : 1 000 milliards selon le blog, 1 050 milliards selon la documentation technique, et un plus vague « >1 000 milliards » dans son dossier légal au titre de l'AI Act européen. Les articles de lancement de VentureBeat citaient séparément 49 milliards de paramètres actifs, un chiffre qui n'apparaît nulle part dans les documents actuels de Mistral.
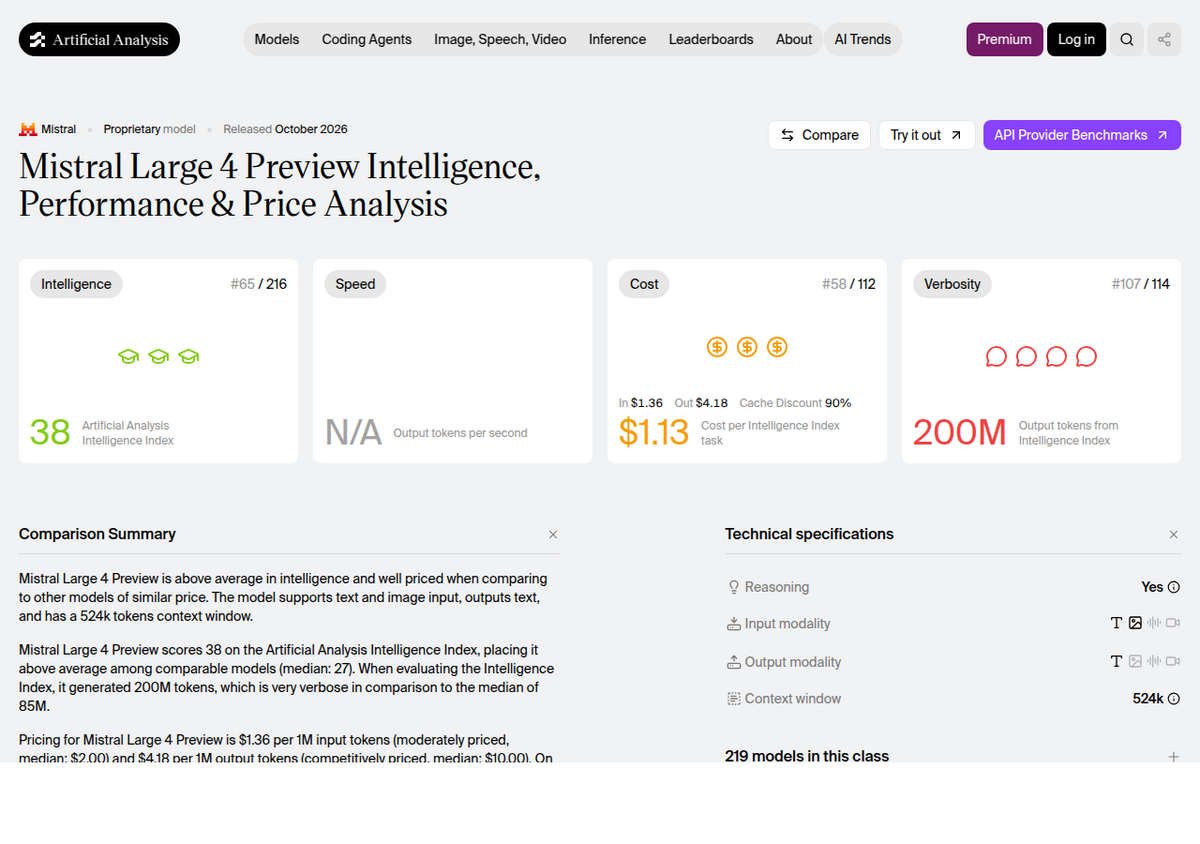
La fenêtre de contexte présente un écart similaire. Mistral annonce 1 million de tokens. Les comparateurs indépendants Artificial Analysis et Vals.ai mesurent tous deux, en pratique, quelque chose de plus proche de 512 000 à 524 000 tokens, et même l'encart de spécifications et la FAQ d'Artificial Analysis se contredisent entre eux (524 000 contre 520 000).
De façon indépendante, il obtient un score honorable, mais pas de niveau frontière. Artificial Analysis le place à 38 sur son Intelligence Index, au rang 65 sur 216 modèles suivis, au-dessus de la médiane de sa catégorie mais loin derrière Claude Opus 5.5 (58) et plusieurs modèles ouverts chinois.
Il n'est accessible qu'en API aujourd'hui, sans palier gratuit. Les poids ouverts sont promis « pour fin octobre » selon Mistral, sans date confirmée ; une remise de lancement limitée dans le temps de 50 % ramène le prix à 0,68 $/2,09 $ par million de tokens en entrée/sortie jusqu'à environ le 20 octobre.
Ce qu'est réellement Mistral Large 4
Mistral Large 4 est un modèle Mixture-of-Experts que Mistral décrit comme un système « hybride instruct-et-raisonnement à poids ouverts », avec une entrée multimodale et une sortie uniquement textuelle : il accepte du texte et des images (jusqu'à 8 par requête, selon le propre dossier de conformité de Mistral au titre de l'AI Act européen), mais ne renvoie jamais que du texte, sans génération d'images. Il comprend un encodeur visuel séparé de 1,6 milliard de paramètres pour la partie image, un détail confirmé dans la documentation technique de Mistral mais absent du billet de blog de l'entreprise et de la majorité de la couverture presse. L'API expose un paramètre reasoning_effort, cohérent avec ce cadrage de « raisonnement hybride » : on peut régler l'intensité de réflexion du modèle avant qu'il ne réponde, en échangeant de la latence contre de la qualité.
Mistral l'a entraîné sur environ 3 800 GPU Nvidia Grace Blackwell (chiffre propre de Mistral ; la presse arrondit à « environ 4 000 ») pendant environ deux mois, couvrant plus de 160 langues, dont toutes les langues officielles de l'UE. Pierre Stock, VP Science de Mistral, a déclaré à TechCrunch que l'entraînement avait utilisé « deux à trois fois moins » de calcul que des concurrents chinois non nommés, une affirmation d'efficacité à noter comme venant de l'entreprise elle-même plutôt que vérifiée de façon indépendante. Un détail à prendre au sérieux avant de juger le modèle trop durement sur un seul benchmark : le blog de Mistral indique que l'entraînement par renforcement était « encore en cours » au moment du lancement, ce qui signifie que la version de préversion publique est explicitement un modèle inachevé, pas la version finale de Mistral.
Le surnom « Le Chonk » a une origine précise et vérifiable : en juin 2026, une blague s'est répandue en ligne à propos d'un modèle fictif appelé « Le Chaton Fat », avec des benchmarks fabriqués affichant 30 000 milliards de paramètres. Le PDG de Mistral, Arthur Mensch, avait joué le jeu sur les réseaux sociaux à l'époque, et quand Mistral Large 4 est réellement sorti comme un modèle vraiment surdimensionné plusieurs mois plus tard, le surnom interne est resté, Mensch aurait plaisanté en disant que c'était « en fait le gros chaton ». C'est un petit détail, mais le genre de chose qui montre que Mistral est consciente de son positionnement de « gros modèle », et à l'aise avec, cette fois-ci.
Le nombre total de paramètres dépend de la page de Mistral que l'on consulte
Source                                Total params      Active params
---------------------------------------------------------------------------
Mistral's launch blog post             1 trillion         52 billion
docs.mistral.ai model page              1.05 trillion       52 billion
VentureBeat (launch-day reporting)      1 trillion          49 billion
EU AI Act technical documentation       ">1 trillion"       not disclosed
  (legal filing)

Mistral's blog and technical docs now agree on 52 billion active
parameters. The total count still varies across Mistral's own materials,
and VentureBeat's widely-repeated 49 billion figure doesn't appear in any
current Mistral-published page we could find.
Ce dossier légal mérite un second regard, pour une autre raison. La documentation technique de Mistral au titre de l'AI Act européen destinée aux fournisseurs en aval, la déclaration de conformité exigée pour opérer dans l'UE, indique une entrée et une sortie de texte maximales fixées à seulement « 250 tokens ». Ce chiffre est presque certainement un champ de modèle que Mistral n'a jamais correctement rempli, plutôt qu'une vraie limite (toutes les autres sources, y compris la propre documentation de Mistral, indiquent une fenêtre de contexte allant de plusieurs centaines de milliers à un million de tokens), mais c'est une bizarrerie réelle et vérifiable dans les propres documents officiels de Mistral : nous avons affiché le dossier directement plutôt que de nous appuyer sur une extraction de texte automatisée, et le chiffre est imprimé exactement ainsi. Ne citez pas les 250 tokens comme une contrainte réelle ; voyez-y plutôt un signe que la documentation de conformité de Mistral pour ce lancement a été bâclée.
Fenêtre de contexte : 1 million de tokens annoncé, environ la moitié mesurée
La documentation de Mistral indique une fenêtre de contexte de 1 000 000 de tokens, le chiffre repris dans la majorité de la couverture du lancement. Les comparateurs d'API indépendants mesurent quelque chose de plus petit en pratique : Vals.ai indique une fenêtre de contexte de 512 000 tokens avec une sortie maximale de 256 000 tokens, et l'encart de spécifications d'Artificial Analysis se contredit avec sa propre page de FAQ, 524 000 contre 520 000 tokens. Aucun de ces trois chiffres indépendants ne correspond à l'annonce de 1M de Mistral, et les deux comparateurs indépendants ne s'accordent même pas précisément entre eux. Si un flux de travail dépend réellement de l'usage complet de cette fenêtre d'un million de tokens, testez-le avec votre propre document long avant de construire quoi que ce soit autour de ce chiffre ; l'écart entre la capacité annoncée et la capacité mesurée est ici assez large pour avoir de l'importance.
Le prix, et une remise déjà en train de s'épuiser
Tier                      Input ($/M tokens)   Output ($/M tokens)
---------------------------------------------------------------------
List price                 1.36                  4.18
Launch discount (50% off,   0.68                  2.09
  ~2 weeks from 6 Oct)
Cached input, discounted    0.07                  n/a

Mistral's own changelog states the discount runs roughly two weeks from
launch, putting the likely end date around 20 October 2026. No exact end
date is published on the pricing page itself, so confirm the live price
on Mistral's own console before relying on it.
Comment il se classe, mesuré de façon indépendante
Artificial Analysis, qui fait tourner chaque modèle via le même Intelligence Index standardisé plutôt que de reprendre le score auto-déclaré d'un fournisseur, place Mistral Large 4 à 38, classé 65e sur 216 modèles suivis, contre une médiane de catégorie d'environ 26-27. C'est un résultat réellement au-dessus de la moyenne, et un grand bond par rapport au précédent modèle phare de Mistral (davantage à ce sujet plus bas), mais ce n'est pas un résultat de pointe : Claude Opus 5.5 domine le classement à 58, Claude Sonnet 5.5 se situe à 51,9, et plusieurs modèles ouverts chinois, MiMo-V2.6-Pro (46), GLM-5.3 (45) et Qwen 3.8 Max (45,4), obtiennent tous un score supérieur à Mistral Large 4 sur le même index. Le cadrage de Mistral elle-même, « le modèle le plus puissant hors des États-Unis et de la Chine », se vérifie face aux concurrents occidentaux fermés comme GPT-6 Luna (environ 37-38), mais pas face à ces modèles ouverts chinois, ce qui constitue une affirmation sensiblement plus étroite que ne le suggère le titre. Pour donner une échelle, l'autre grand lancement de la même semaine, le palier accessible par API de Muse Wonder de Meta, obtient 52 sur le même index indépendant, largement devant Mistral Large 4.
Deux chiffres indépendants comptent davantage que le score affiché si vous décidez d'utiliser réellement ce modèle. D'abord, le taux d'hallucination : la mesure AA-Omniscience d'Artificial Analysis le place à 41,9 %, signalé par le testeur indépendant eesel.ai comme le plus gros point faible de ce lancement, à connaître avant de l'utiliser pour tout ce où une réponse fausse mais confiante coûterait cher. Ensuite, la forme de la latence : une fois le flux lancé, la sortie tourne à un rythme raisonnable de 116 tokens par seconde, mais le délai avant le premier token sur les longs prompts a été mesuré à environ 18,7 secondes, rapide une fois lancé, lent à démarrer. C'est une mauvaise combinaison pour une interface de discussion en direct, et une bonne pour une tâche en lot qui peut tolérer un délai de démarrage.
Vals.ai, un autre comparateur indépendant avec un ensemble de comparaison différent, davantage orienté vers des modèles de pointe plus puissants, lui donne un score relatif plus bas : 48,05 % sur le Vals Index, rang 35 sur 47. Sa meilleure performance relative est le Legal Agent Benchmark de Harvey, une tâche sur des documents juridiques où il se classe 9e sur 79, un rang honorable même si le score brut (15,83 %) paraît peu impressionnant en lui-même, les benchmarks de raisonnement juridique de ce type obtenant généralement des scores bas dans l'ensemble. Sa performance la plus faible est MysteryMechanism, où il termine bon dernier, 27e sur 27. Sur la cybersécurité en particulier, les chiffres auto-déclarés de Mistral (82-93 % sur des tâches de reproduction et correction de vulnérabilités) appellent une réserve que les testeurs d'apidog ont directement signalée : Claude Opus 5.5 et GPT-6 Astra obtiennent un score proche de zéro sur la même comparaison auto-déclarée, non pas parce qu'ils sont incapables d'accomplir la tâche, mais parce qu'ils la refusent pour des raisons de sécurité. C'est une différence de méthodologie, pas un pur écart de capacité, et les propres documents de Mistral ne clarifient pas cette distinction.
Mistral Large 4 vs. Mistral Large 3
                          Mistral Large 3        Mistral Large 4
------------------------------------------------------------------------
Total / active params      675B / 41B             ~1T-1.05T / 52B
Training hardware          3,000 Nvidia H200       3,800 Nvidia Blackwell
Released                    ~December 2025          6 October 2026
AA Intelligence Index       9                       38 (~4.2x higher)
Verbosity (output tokens     9.8M                    200M (~20x more
  to run full Index)                                  verbose)
Cost per Index task          $0.03                   $1.13 (~38x higher)

Intelligence Index, verbosity and cost figures are Artificial Analysis's
own independent measurements, not Mistral-reported.
Le bond de capacité entre Large 3 et Large 4 est réel et substantiel selon la mesure indépendante d'Artificial Analysis, environ 4 fois le score Intelligence Index. Il a un coût élevé : le modèle est environ 20 fois plus verbeux sur la même évaluation, et le prix pour exécuter une seule tâche d'Intelligence Index est passé de 0,03 $ à 1,13 $, soit environ 38 fois plus. Si vous envisagez de migrer un flux de travail construit sur Large 3, budgétez explicitement cette hausse de coût plutôt que de présumer qu'un modèle plus récent et plus intelligent coûtera automatiquement moins cher à exécuter par tâche.
Poids ouverts : « fin octobre », mais non confirmé
Le blog et le journal des modifications de Mistral décrivent tous deux les poids ouverts comme arrivant « d'ici la fin du mois » ou simplement « prochainement », sans date précise. Les articles de VentureBeat indiquent un objectif précis au 27 octobre 2026, présenté comme la fin d'une période de test d'environ trois semaines avec des développeurs, des chercheurs en cybersécurité et des autorités gouvernementales, mais cette date est une déduction propre à VentureBeat à partir du cadrage « trois semaines » de Mistral, pas une date que Mistral a elle-même publiée. La couverture de TechCrunch est encore plus vague, citant « seulement trois semaines » après le lancement du 6 octobre. Considérez fin octobre comme globalement juste, et le 27 octobre précisément comme non confirmé. La licence de l'éventuelle publication ouverte n'est pas non plus finalisée : VentureBeat rapporte que Mistral s'attend à utiliser une licence personnalisée plutôt qu'une licence standard comme Apache 2.0 ou MIT, mais cela non plus n'a pas été publié, et l'accès actuel n'est régi que par les conditions d'utilisation et l'accord d'auto-déploiement de Mistral.
Comment y accéder aujourd'hui
À l'heure actuelle, la seule façon confirmée d'utiliser Mistral Large 4 est de passer par la propre documentation API de Mistral ou la console Mistral Studio, sous l'identifiant de modèle mistral-large-4 (indiqué sur la page de documentation comme mistral-large-4-0). TechCrunch décrit spécifiquement l'accès actuel comme limité à « un point de terminaison public avec garde-fous », à garder en tête si vous avez besoin d'un accès sans restriction pour une charge de travail sensible. Il est également déjà listé sur des passerelles tierces, dont OpenRouter (sous le nom mistralai/mistral-large-4-0), Eden AI et LLMGateway. Nous n'avons pas pu confirmer s'il est déjà actif dans Vibe, l'application de discussion grand public de Mistral (renommée depuis Le Chat en mai 2026, les comptes et abonnements ayant été conservés) ; l'annonce de Mistral renvoie vers Vibe sans indiquer que le modèle y est disponible, donc vérifiez directement sur chat.mistral.ai avant de présumer que vous pouvez l'essayer gratuitement là-bas.
Faut-il l'utiliser
- Hébergement souverain dans l'UE ou travail multilingue sur les langues officielles de l'UE : un choix pertinent, et l'un des éléments de différenciation les plus nets de Mistral face aux laboratoires américains et chinois.
- Documents juridiques ou de conformité longs : son classement au Legal Agent Benchmark de Harvey (9e sur 79, mesuré de façon indépendante) suggère une vraie force sur ce terrain, même si le score brut reste modeste en valeur absolue.
- Discussion en direct ou applications sensibles à la latence : un choix moins adapté, étant donné le délai d'environ 18,7 secondes avant le premier token sur les longs prompts, même si la vitesse de sortie une fois lancée est correcte.
- Tout cas où une réponse fausse mais confiante coûte cher : le taux d'hallucination de 41,9 % mesuré de façon indépendante est le point faible le plus cité par les testeurs ; vérifiez les sorties plutôt que de leur faire confiance d'emblée.
- Codage de pointe ou travail agentique sensible à la latence : un choix moins adapté. Son Intelligence Index Artificial Analysis (38) reste derrière plusieurs modèles ouverts chinois (MiMo-V2.6-Pro à 46, GLM-5.3 à 45, Qwen 3.8 Max à 45,4), eux aussi à poids ouverts, une comparaison qui comptera probablement le plus pour les développeurs en train de choisir un modèle de codage.
Questions fréquentes
Mistral Large 4 est-il gratuit ?
Aucun palier gratuit n'existe. C'est uniquement accessible via API, facturé au token, avec une remise de lancement limitée dans le temps de 50 % (environ 0,68 $/2,09 $ par million de tokens en entrée/sortie) que le propre journal des modifications de Mistral indique courir environ deux semaines à partir du lancement du 6 octobre 2026.
Mistral Large 4 est-il open source ou à poids ouverts ?
Pas encore. Mistral le décrit comme destiné à être à poids ouverts et promet les poids « pour fin octobre » 2026, VentureBeat rapportant un objectif précis mais non confirmé au 27 octobre. La licence n'a pas été finalisée ; Mistral s'attend à utiliser une licence personnalisée plutôt qu'une licence standard comme Apache 2.0.
Combien de paramètres compte Mistral Large 4 ?
52 milliards de paramètres actifs, un chiffre sur lequel le blog et la documentation technique de Mistral s'accordent désormais. Le nombre total de paramètres varie encore selon les documents de Mistral : 1 000 milliards selon le blog de lancement, 1 050 milliards selon la documentation technique. Les articles de lancement de VentureBeat citaient séparément 49 milliards de paramètres actifs, un chiffre introuvable dans les pages actuelles de Mistral.
Quelle est la fenêtre de contexte réelle de Mistral Large 4 ?
Mistral annonce 1 million de tokens. Les comparateurs indépendants mesurent moins en pratique : Vals.ai indique 512 000 tokens, et l'encart de spécifications d'Artificial Analysis se contredit avec sa propre FAQ, à 524 000 contre 520 000 tokens.
Comment Mistral Large 4 se compare-t-il à Mistral Large 3 ?
Environ 1,5 fois le nombre total de paramètres, sur du matériel Nvidia Blackwell plus récent. De façon indépendante, Artificial Analysis mesure un bond d'environ 4x du score Intelligence Index (de 9 à 38), mais avec une verbosité de sortie environ 20 fois plus élevée et un coût d'évaluation par tâche passant de 0,03 $ à 1,13 $, soit environ 38 fois plus.
Mistral Large 4 hallucine-t-il beaucoup ?
La mesure AA-Omniscience d'Artificial Analysis place son taux d'hallucination à 41,9 %, signalé par le testeur indépendant eesel.ai comme le plus gros point faible du modèle. Vérifiez les sorties factuelles plutôt que de leur faire confiance d'emblée, en particulier sur des sujets peu familiers ou de niche.
Dans quoi Mistral Large 4 excelle-t-il ?
Parmi ses forces mesurées de façon indépendante : le travail juridique et sur documents longs (un rang honorable au Legal Agent Benchmark de Harvey) et les tâches de reproduction de vulnérabilités en cybersécurité, bien que les scores cyber auto-déclarés par Mistral appellent la réserve suivante : certains modèles rivaux obtiennent un score proche de zéro sur le même test parce qu'ils refusent la tâche pour des raisons de sécurité, pas parce qu'ils en sont incapables.
Exportez votre NotebookLM en un clic
Extension Chrome gratuite. PDF, Word et Markdown. Généré sur votre machine — rien n'est envoyé en ligne.