Mistral Large 4, explicado: un modelo de un billón de parámetros, y las specs en las que ni las propias páginas de Mistral se ponen de acuerdo
Mistral AI lanzó Mistral Large 4 en vista previa pública el 6 de octubre de 2026, apodado internamente "Le Chonk" por un meme sobre un modelo ficticio y descomunal que se hizo viral meses antes. Es un salto genuinamente grande para Mistral, y también un lanzamiento en el que la propia documentación, la entrada de blog y los expedientes legales de la empresa citan cifras distintas de parámetros y de tamaño de ventana de contexto para el mismo modelo. Esto es lo que está realmente confirmado, dónde está la ambigüedad real, y cómo puntúa de forma independiente frente al campo de vanguardia.
Mistral Large 4 se lanzó en vista previa pública el 6 de octubre de 2026, un modelo Mixture-of-Experts con 52.000 millones de parámetros activos, una cifra en la que ya coinciden el propio blog de Mistral y su documentación técnica. Donde los materiales de Mistral todavía no coinciden es en el total de parámetros: 1 billón según el blog, 1,05 billones según la documentación técnica, y un más vago «>1 billón» en su expediente legal de la Ley de IA de la UE. La cobertura de VentureBeat del día del lanzamiento citó por separado 49.000 millones de parámetros activos, una cifra que no aparece en ninguna parte de los materiales actuales de Mistral.
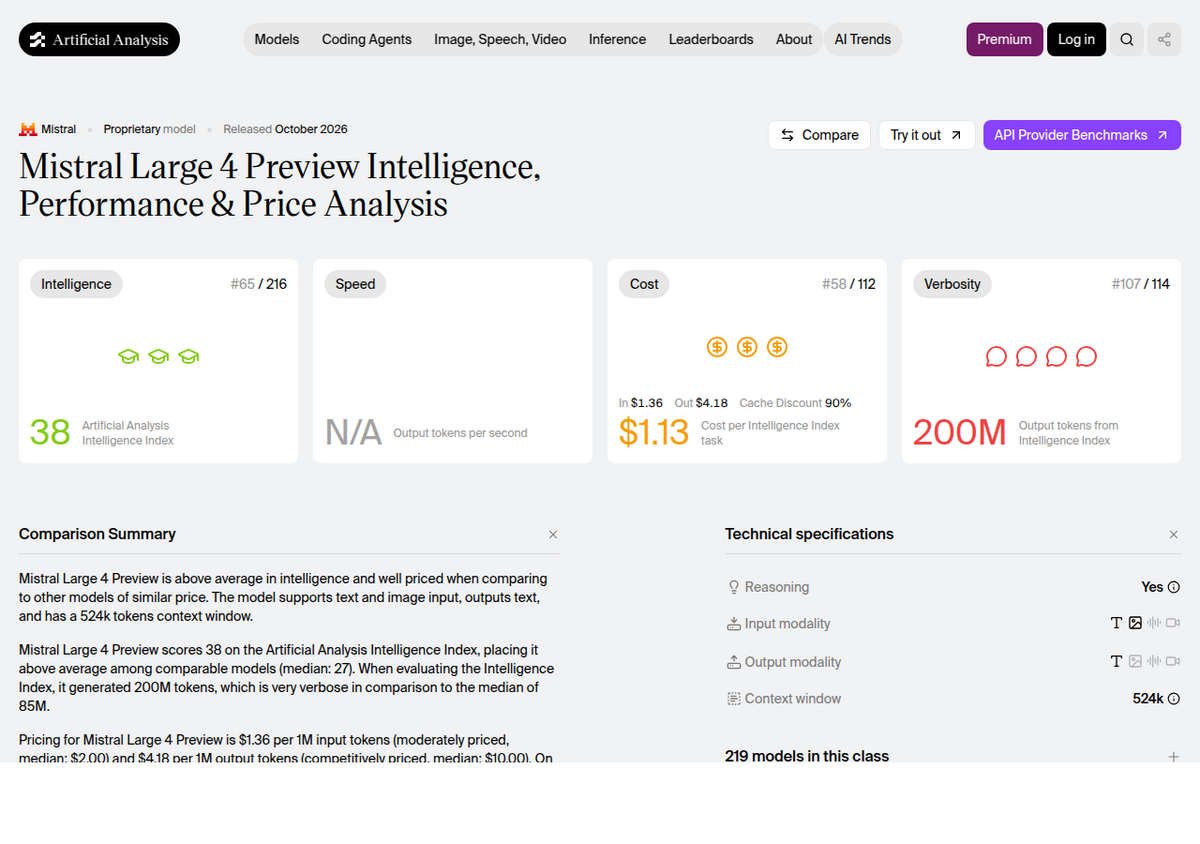
La ventana de contexto tiene una brecha similar. Mistral indica 1 millón de tokens. Los rastreadores independientes Artificial Analysis y Vals.ai miden en la práctica una cifra más cercana a 512.000-524.000 tokens, e incluso el propio cuadro de especificaciones y la FAQ de Artificial Analysis no coinciden entre sí (524k frente a 520k).
De forma independiente, puntúa de manera respetable, pero no está en la vanguardia. Artificial Analysis lo sitúa en 38 en su Intelligence Index, en el puesto 65 de 216 modelos rastreados, por encima de la mediana de su categoría, pero muy por detrás de Claude Opus 5.5 (58) y de varios modelos chinos de pesos abiertos.
Hoy solo está disponible por API, sin nivel gratuito. Mistral promete pesos abiertos "a finales de octubre", sin fecha confirmada; un descuento de lanzamiento del 50%, limitado en el tiempo, deja el precio en 0,68 $/2,09 $ por millón de tokens de entrada/salida hasta aproximadamente el 20 de octubre.
Qué es realmente Mistral Large 4
Mistral Large 4 es un modelo Mixture-of-Experts que Mistral describe como un sistema «híbrido de instrucciones y razonamiento de pesos abiertos» con entrada multimodal y salida solo de texto: acepta texto e imágenes (hasta 8 por solicitud, según el propio expediente de cumplimiento de la Ley de IA de la UE de Mistral), pero solo devuelve texto, sin generación de imágenes. Incluye un codificador de visión independiente de 1.600 millones de parámetros para el lado de la imagen, un detalle confirmado en la documentación técnica de Mistral pero ausente de la propia entrada de blog de la empresa y de la mayoría de la cobertura de prensa. La API expone un parámetro reasoning_effort, coherente con el planteamiento de «razonamiento híbrido»: puedes ajustar cuánto piensa el modelo antes de responder, intercambiando latencia por calidad.
Mistral lo entrenó en aproximadamente 3.800 GPU Nvidia Grace Blackwell (cifra de la propia Mistral; la prensa la redondea a «unas 4.000») durante unos dos meses, cubriendo más de 160 idiomas, incluidos todos los idiomas oficiales de la UE. Pierre Stock, VP de Ciencia de Mistral, declaró a TechCrunch que el entrenamiento usó «de dos a tres veces menos» cómputo que competidores chinos sin nombrar, una afirmación de eficiencia que conviene señalar como procedente de la propia empresa y no verificada de forma independiente. Un detalle que merece tomarse en serio antes de juzgar con demasiada dureza al modelo por un solo benchmark: el propio blog de Mistral indica que el entrenamiento por refuerzo todavía estaba «en curso» en el momento del lanzamiento, lo que significa que el checkpoint de vista previa pública es explícitamente un modelo sin terminar, no la versión final de Mistral.
El apodo «Le Chonk» tiene un origen concreto y verificable: en junio de 2026 se difundió por internet una broma sobre un modelo ficticio llamado «Le Chaton Fat» con benchmarks inventados de 30 billones de parámetros. El CEO de Mistral, Arthur Mensch, siguió la broma en redes sociales en su momento, y cuando Mistral Large 4 acabó saliendo meses después como un modelo genuinamente descomunal, el apodo interno se quedó, con Mensch bromeando según se cuenta que en realidad es «le gros chaton». Es un detalle pequeño, pero del tipo que indica que esta vez Mistral es consciente de su propio posicionamiento de «modelo grande», y se siente cómoda con él.
El total de parámetros depende de qué página de Mistral leas
Source                                Total params      Active params
---------------------------------------------------------------------------
Mistral's launch blog post             1 trillion         52 billion
docs.mistral.ai model page              1.05 trillion       52 billion
VentureBeat (launch-day reporting)      1 trillion          49 billion
EU AI Act technical documentation       ">1 trillion"       not disclosed
  (legal filing)

Mistral's blog and technical docs now agree on 52 billion active
parameters. The total count still varies across Mistral's own materials,
and VentureBeat's widely-repeated 49 billion figure doesn't appear in any
current Mistral-published page we could find.
Ese expediente legal merece una segunda mirada por otro motivo. La documentación técnica de Mistral para la Ley de IA de la UE dirigida a proveedores subsiguientes, la declaración de cumplimiento exigida para operar en la UE, indica que la entrada y salida máxima de texto del modelo es de «250 tokens», sin más matices. Esa cifra es casi con toda seguridad un campo de plantilla que Mistral nunca rellenó correctamente, y no un límite real (todas las demás fuentes, incluida la propia documentación de Mistral, indican una ventana de contexto de cientos de miles hasta un millón de tokens), pero es una rareza genuina y verificable en el propio papeleo oficial de Mistral: renderizamos el expediente directamente en lugar de confiar en una extracción automática de texto, y la cifra aparece impresa exactamente así. No cites 250 tokens como una restricción real; sí trata esto como una señal de que la documentación de cumplimiento de Mistral para este lanzamiento se hizo con prisas.
Ventana de contexto: se anuncia 1 millón de tokens, se mide casi la mitad
La propia documentación de Mistral indica una ventana de contexto de 1.000.000 de tokens, la cifra que repite la mayoría de la cobertura del lanzamiento. Los rastreadores independientes de la API miden en la práctica algo menor: Vals.ai indica una ventana de contexto de 512.000 tokens con una salida máxima de 256.000 tokens, y el cuadro de especificaciones de Artificial Analysis no coincide con su propia página de FAQ, 524.000 frente a 520.000 tokens. Ninguna de estas tres cifras independientes coincide con el 1M que afirma Mistral, y ni siquiera los dos rastreadores independientes coinciden exactamente entre sí. Si un flujo de trabajo depende de usar de verdad toda la ventana de un millón de tokens, pruébalo con tu propio documento largo antes de construir algo que dé por hecha esa cifra; la brecha entre la capacidad anunciada y la medida aquí es lo bastante grande como para importar.
Precio, y un descuento cuya cuenta atrás ya corre
Tier                      Input ($/M tokens)   Output ($/M tokens)
---------------------------------------------------------------------
List price                 1.36                  4.18
Launch discount (50% off,   0.68                  2.09
  ~2 weeks from 6 Oct)
Cached input, discounted    0.07                  n/a

Mistral's own changelog states the discount runs roughly two weeks from
launch, putting the likely end date around 20 October 2026. No exact end
date is published on the pricing page itself, so confirm the live price
on Mistral's own console before relying on it.
Cómo puntúa, medido de forma independiente
Artificial Analysis, que ejecuta todos los modelos a través del mismo Intelligence Index estandarizado en lugar de fiarse de la cifra que reporta cada proveedor, sitúa a Mistral Large 4 en 38, en el puesto 65 de 216 modelos rastreados, frente a una mediana de categoría de aproximadamente 26-27. Es un resultado genuinamente por encima de la media y un salto grande respecto al anterior buque insignia de Mistral (más sobre esto más abajo), pero no es un resultado de vanguardia: Claude Opus 5.5 encabeza la tabla con 58, Claude Sonnet 5.5 se sitúa en 51,9, y varios modelos chinos de pesos abiertos, MiMo-V2.6-Pro (46), GLM-5.3 (45) y Qwen 3.8 Max (45,4), puntúan todos más alto que Mistral Large 4 en el mismo índice. El propio planteamiento de Mistral, «el modelo más fuerte fuera de EE. UU. y China», se sostiene frente a competidores occidentales cerrados como GPT-6 Luna (aproximadamente 37-38), pero no frente a esos modelos chinos abiertos, lo cual es una afirmación significativamente más limitada de lo que sugiere el titular. Como referencia de escala, el otro gran lanzamiento de la misma semana, el nivel accesible por API de Meta Muse Wonder, puntúa 52 en el mismo índice independiente, muy por delante de Mistral Large 4.
Dos cifras independientes importan más que la puntuación titular si estás decidiendo si usar de verdad este modelo. Primero, la tasa de alucinación: la medición AA-Omniscience de Artificial Analysis la sitúa en 41,9%, señalada por el revisor independiente eesel.ai como el punto débil más importante de este lanzamiento, algo que conviene saber antes de usarlo para cualquier cosa en la que una respuesta segura pero incorrecta salga cara. Segundo, la forma de la latencia: una vez empieza a transmitir, la salida corre a un razonable 116 tokens por segundo, pero el tiempo hasta el primer token en prompts largos se midió en torno a 18,7 segundos, rápido una vez arranca, lento para empezar. Es una mala combinación para una interfaz de chat en vivo y una buena para un trabajo por lotes que pueda tolerar un retraso de arranque.
Vals.ai, un rastreador independiente distinto con un conjunto de comparación diferente y más inclinado hacia modelos de vanguardia más fuertes, lo puntúa más bajo en términos relativos: 48,05% en el Vals Index, puesto 35 de 47. Su mejor resultado relativo es el Legal Agent Benchmark de Harvey, una tarea de documentos legales en la que se sitúa en el puesto 9 de 79, una posición respetable aunque la puntuación en bruto (15,83%) parezca poco impresionante por sí sola, ya que los benchmarks de razonamiento legal de este tipo puntúan bajo en general. Su peor resultado es MysteryMechanism, donde termina en último lugar, puesto 27 de 27. En ciberseguridad en concreto, las cifras autoinformadas por la propia Mistral (82-93% en tareas de reproducción y parcheo de vulnerabilidades) necesitan una advertencia que los revisores de apidog señalaron directamente: Claude Opus 5.5 y GPT-6 Astra puntúan cerca de cero en la misma comparación autoinformada, no porque no puedan hacer la tarea, sino porque se niegan a hacerla por motivos de seguridad. Esa es una diferencia de metodología, no una brecha pura de capacidad, y los propios materiales de Mistral no dejan clara esa distinción.
Mistral Large 4 frente a Mistral Large 3
                          Mistral Large 3        Mistral Large 4
------------------------------------------------------------------------
Total / active params      675B / 41B             ~1T-1.05T / 52B
Training hardware          3,000 Nvidia H200       3,800 Nvidia Blackwell
Released                    ~December 2025          6 October 2026
AA Intelligence Index       9                       38 (~4.2x higher)
Verbosity (output tokens     9.8M                    200M (~20x more
  to run full Index)                                  verbose)
Cost per Index task          $0.03                 $1.13 (~38x higher)

Intelligence Index, verbosity and cost figures are Artificial Analysis's
own independent measurements, not Mistral-reported.
El salto de capacidad de Large 3 a Large 4 es real y sustancial según la medición independiente de Artificial Analysis, aproximadamente 4 veces la puntuación del Intelligence Index. Llega con un coste pronunciado: el modelo es unas 20 veces más verboso en la misma evaluación, y el precio de ejecutar una sola tarea del Intelligence Index subió de 0,03 $ a 1,13 $, aproximadamente 38 veces más. Si estás valorando si actualizar un flujo de trabajo construido sobre Large 3, presupuesta explícitamente ese incremento de coste en lugar de asumir que un modelo más nuevo y más inteligente es automáticamente más barato de ejecutar por tarea.
Pesos abiertos: «finales de octubre», pero sin confirmar
Tanto el blog como el changelog de Mistral describen los pesos abiertos como algo que llegará «a finales de mes» o simplemente «próximamente», sin fecha concreta. La cobertura de VentureBeat indica un objetivo concreto, el 27 de octubre de 2026, planteado como el final de un periodo de pruebas de unas tres semanas con desarrolladores, investigadores de ciberseguridad y autoridades gubernamentales, pero esa fecha es una inferencia propia de VentureBeat a partir del planteamiento de «tres semanas» de Mistral, no una fecha que la propia Mistral haya publicado. La cobertura de TechCrunch es todavía más vaga, y cita «solo tres semanas» después del lanzamiento del 6 de octubre. Trata finales de octubre como correcto en cuanto a dirección, y el 27 de octubre en concreto como sin confirmar. La licencia para la eventual publicación abierta tampoco está finalizada: VentureBeat informa de que Mistral espera usar una licencia personalizada de Mistral en lugar de una estándar como Apache 2.0 o MIT, pero eso tampoco se ha publicado, y el acceso actual se rige solo por los términos de servicio y el acuerdo de autodespliegue de Mistral.
Cómo acceder a él hoy
Ahora mismo, la única forma confirmada de usar Mistral Large 4 es a través de la propia documentación de la API de Mistral o de la consola de Mistral Studio, con el ID de modelo mistral-large-4 (listado en la página de documentación como mistral-large-4-0). TechCrunch describe específicamente el acceso actual como limitado a «un endpoint público con barreras de seguridad», algo que conviene tener en cuenta si necesitas acceso sin restricciones para una carga de trabajo sensible. También ya aparece listado en pasarelas de terceros, incluidas OpenRouter (como mistralai/mistral-large-4-0), Eden AI y LLMGateway. No pudimos confirmar si ya está activo dentro de Vibe, la propia app de chat para consumidores de Mistral (renombrada desde Le Chat en mayo de 2026, con las cuentas y suscripciones mantenidas); el anuncio de Mistral enlaza a Vibe sin afirmar que el modelo esté disponible allí, así que verifícalo directamente en chat.mistral.ai antes de dar por hecho que puedes probarlo gratis ahí.
¿Deberías usarlo?
- Alojamiento con soberanía de la UE o trabajo multilingüe en los idiomas oficiales de la UE: un ajuste razonable, y uno de los diferenciadores más claros de Mistral frente a los laboratorios de EE. UU. y China.
- Documentos legales o de cumplimiento largos: el puesto en el Legal Agent Benchmark de Harvey (9º de 79, medido de forma independiente) sugiere una fortaleza real aquí, aunque la puntuación en bruto sea modesta en términos absolutos.
- Chat en vivo o aplicaciones sensibles a la latencia: un ajuste más débil, dado el tiempo hasta el primer token de unos 18,7 segundos en prompts largos, aunque la velocidad de salida una vez arranca sea correcta.
- Cualquier cosa en la que una respuesta segura pero incorrecta salga cara: la tasa de alucinación del 41,9%, medida de forma independiente, es el punto débil más citado entre los revisores; verifica las salidas en lugar de confiar en ellas sin más.
- Programación de vanguardia o trabajo agéntico sensible a la latencia: un ajuste más débil. Su Intelligence Index de Artificial Analysis (38) queda por detrás de varios modelos chinos abiertos (MiMo-V2.6-Pro con 46, GLM-5.3 con 45, Qwen 3.8 Max con 45,4) que también son de pesos abiertos, una comparación que probablemente importe más a los desarrolladores que elijan un modelo para programar.
La gente también pregunta
¿Es gratis Mistral Large 4?
No existe ningún nivel gratuito. Solo está disponible por API, facturado por token, con un descuento de lanzamiento del 50%, limitado en el tiempo (aproximadamente 0,68 $/2,09 $ por millón de tokens de entrada/salida), que según el propio changelog de Mistral dura unas dos semanas desde el lanzamiento del 6 de octubre de 2026.
¿Es Mistral Large 4 de código abierto o de pesos abiertos?
Todavía no. Mistral lo describe como pensado para ser de pesos abiertos y promete los pesos «a finales de octubre» de 2026, con VentureBeat informando de un objetivo concreto pero sin confirmar del 27 de octubre. La licencia no se ha finalizado; Mistral espera usar una licencia personalizada en lugar de una estándar como Apache 2.0.
¿Cuántos parámetros tiene Mistral Large 4?
52.000 millones de parámetros activos, una cifra en la que ya coinciden el propio blog de Mistral y su documentación técnica. El total de parámetros todavía varía entre los materiales de Mistral: 1 billón según el blog de lanzamiento, 1,05 billones según la documentación técnica. La cobertura de VentureBeat del día del lanzamiento citó por separado 49.000 millones de parámetros activos, una cifra que no se encuentra en las páginas actuales de Mistral.
¿Cuál es la ventana de contexto real de Mistral Large 4?
Mistral indica 1 millón de tokens. Los rastreadores independientes miden menos en la práctica: Vals.ai indica 512.000 tokens, y el propio cuadro de especificaciones de Artificial Analysis no coincide con su FAQ, 524.000 frente a 520.000 tokens.
¿Cómo se compara Mistral Large 4 con Mistral Large 3?
Aproximadamente 1,5 veces el total de parámetros, sobre hardware Nvidia Blackwell más nuevo. De forma independiente, Artificial Analysis mide un salto de aproximadamente 4 veces en la puntuación del Intelligence Index (de 9 a 38), pero con una verbosidad de salida unas 20 veces mayor y un coste de evaluación por tarea que sube de 0,03 $ a 1,13 $, aproximadamente 38 veces más.
¿Alucina mucho Mistral Large 4?
La medición AA-Omniscience de Artificial Analysis sitúa su tasa de alucinación en el 41,9%, señalada por el revisor independiente eesel.ai como el punto débil más importante del modelo. Verifica las salidas factuales en lugar de confiar en ellas sin más, especialmente en temas poco conocidos o de nicho.
¿En qué es mejor Mistral Large 4?
Entre sus fortalezas medidas de forma independiente están el trabajo legal y con documentos largos (un puesto respetable en el Legal Agent Benchmark de Harvey) y las tareas de reproducción de vulnerabilidades de ciberseguridad, aunque las puntuaciones de ciberseguridad autoinformadas por Mistral necesitan la advertencia de que algunos modelos rivales puntúan cerca de cero en la misma prueba porque se niegan a hacer la tarea por motivos de seguridad, no porque no puedan.
Exporta tu NotebookLM con un clic
Extensión de Chrome gratuita. PDF, Word y Markdown. Generado en tu equipo — nada se sube a la nube.