Claude Sonnet 5.5, expliqué : le modèle bon marché qui continue d'embarrasser le propre vaisseau amiral d'Anthropic
Anthropic a lancé Claude Sonnet 5.5 le 28 septembre 2026, six jours après Claude Opus 5.5 et non avant lui, au même tarif de 2 $ en entrée / 10 $ en sortie par million de tokens que le Sonnet qu'il remplace. Sur deux des benchmarks qui comptent le plus pour le travail quotidien, il se situe à deux points d'Opus 5.5, un modèle deux fois plus cher. Le piège que les concurrents continuent de manquer : au réglage d'effort de raisonnement maximal propre à Anthropic, Sonnet 5.5 consomme tellement plus de tokens par tâche que l'avantage de coût peut complètement s'inverser.
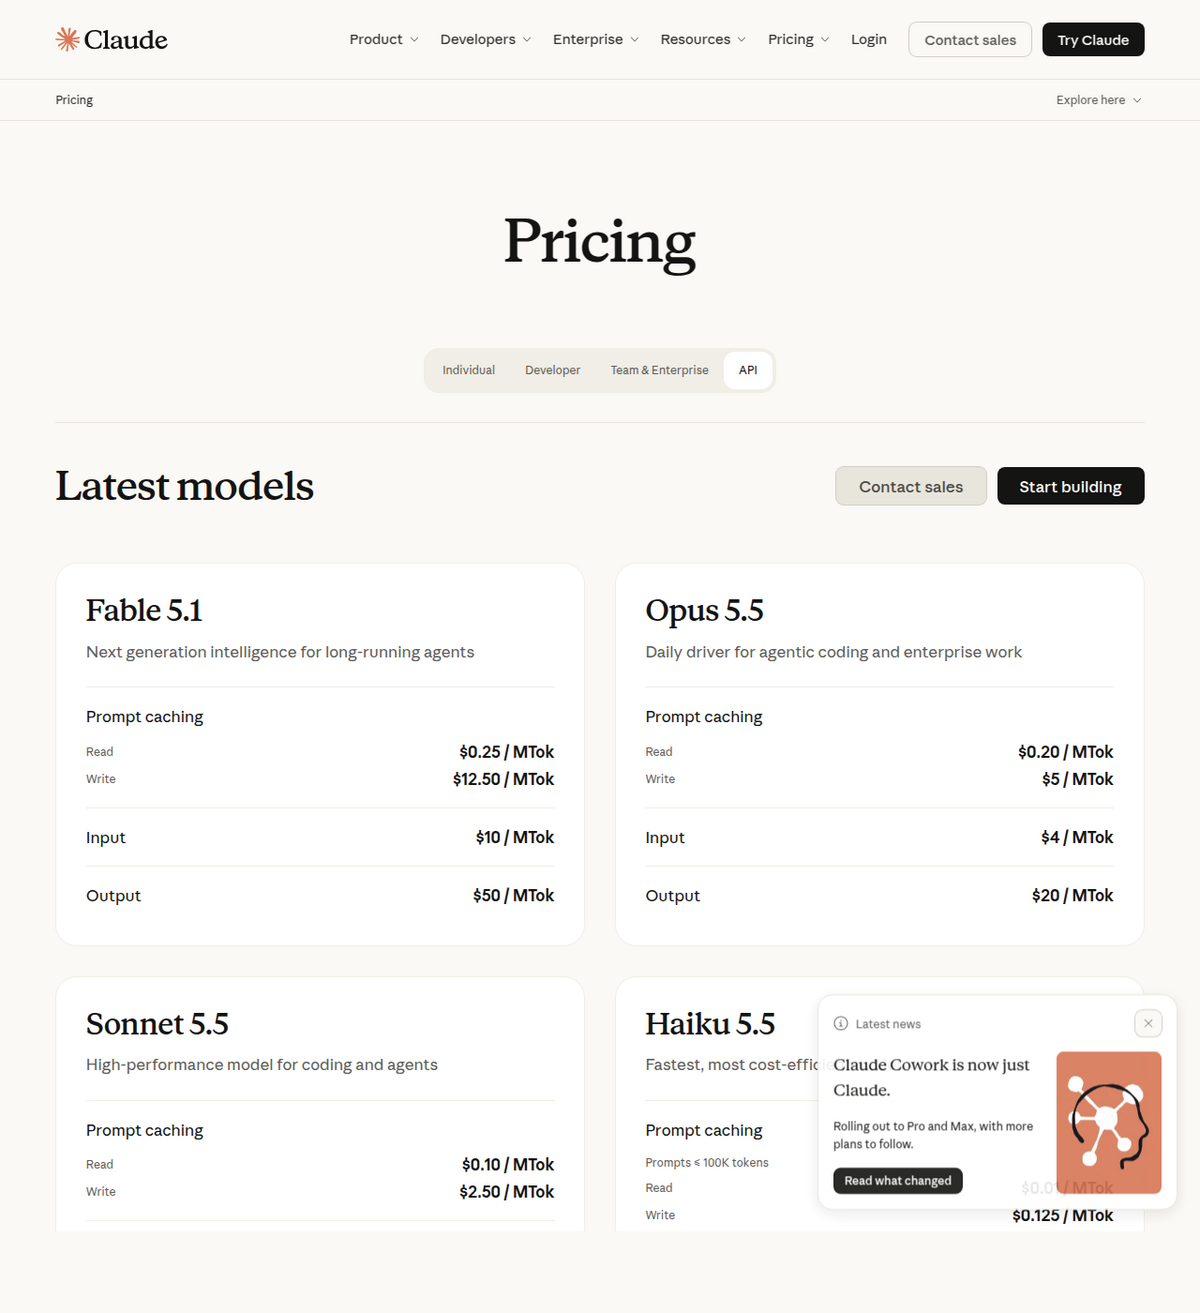
Claude Sonnet 5.5 a été lancé le 28 septembre 2026, la deuxième sortie de la mise à jour « 5.5 » d'Anthropic, six jours après Opus 5.5 (22 septembre). Le prix est inchangé par rapport à Sonnet 5 : 2 $ par million de tokens en entrée, 10 $ par million de tokens en sortie. Le seul tarif qui a changé est facile à manquer : les lectures de cache de prompt sont tombées à 0,10 $ par million de tokens, la moitié de l'ancien tarif de 0,20 $ de Sonnet 5. La plupart des trackers de prix tiers que nous avons vérifiés indiquent encore 0,20 $ comme tarif actuel.
Sur les benchmarks de travail de connaissance et d'usage d'ordinateur, c'est une quasi-égalité avec Opus 5.5 à moitié prix. Sonnet 5.5 obtient 1844 sur GDPval-AA v2.1 contre 1846 pour Opus, et 80,1 % sur OSWorld 2.1 contre 81,8 % pour Opus, des écarts d'un à deux points malgré une différence de prix de 2x.
Le chiffre propre d'Anthropic et le nouveau test d'un laboratoire indépendant ne concordent pas. Anthropic rapporte 70,6 % sur Terminal-Bench 4.0 ; le nouveau test indépendant du même benchmark par Artificial Analysis a obtenu 64 %, toujours devant les 60 % d'Opus 5.5 sur le même harnais, mais un véritable écart entre le chiffre marketing et les résultats reproduits, qu'il vaut la peine de connaître avant de bâtir un plan dessus.
L'affirmation « jusqu'à 30 % moins cher » ne tient pas à tous les réglages. À l'effort de raisonnement maximal, Sonnet 5.5 génère environ 193 000 tokens de sortie par tâche en moyenne, le chiffre le plus élevé qu'Artificial Analysis ait mesuré pour n'importe quel modèle, ce qui porte son coût par tâche à environ 7,60 $, plus élevé que Sonnet 5 et, selon une mesure, plus élevé qu'Opus 5.5 atteignant le même niveau de qualité avec moins de tokens, mais plus chers.
Ce qui est sorti, et dans quel ordre
Notre propre guide sur Opus 5.5 indiquait l'ordre inverse jusqu'à ce que nous le corrigions en préparant cet article. La propre documentation des modèles d'Anthropic liste la sortie d'Opus 5.5 au 22 septembre 2026 et celle de Sonnet 5.5 au 28 septembre 2026, six jours plus tard, et non avant. Cet ordre compte pour la façon de lire la comparaison : Sonnet 5.5 est le second acte, celui qui avait les chiffres de benchmark d'Opus 5.5 à battre, pas l'acte d'ouverture.
L'identifiant du modèle dans l'API est claude-sonnet-5-5, disponible via l'API Claude, Amazon Bedrock, Google Cloud Vertex AI et Microsoft Foundry. La fenêtre contextuelle reste à 1 million de tokens, avec une limite de sortie de 128 000 tokens sur les requêtes standard, extensible à 300 000 tokens sur l'API Batch derrière un en-tête bêta output-300k-2026-03-24. La date limite des connaissances est juin 2026, tant pour l'entraînement que pour la fiabilité du rappel. Un réglage par défaut a changé depuis Sonnet 5 : Sonnet 5.5 raisonne par défaut avec un effort élevé (Opus 5.5 est par défaut à moyen), et son réglage de réflexion manuelle le plus bas est désormais between_tools plutôt que l'ancienne option disabled, un changement cassant si votre intégration désactivait explicitement la réflexion.
Le piège tarifaire : les lectures de cache sont devenues moins chères, et la plupart des trackers l'ont manqué
Les tarifs en entrée et en sortie restent inchangés par rapport à Sonnet 5 : 2 $ par million de tokens en entrée, 10 $ en sortie. C'est la mise en cache de prompt qui a réellement bougé. La documentation d'Anthropic indique que Sonnet 5.5 conserve les mêmes prix que Sonnet 5, « sauf pour les lectures de cache de prompt, qui coûtent 0,10 $ US par million de tokens, la moitié du tarif de Claude Sonnet 5 ». Les écritures de cache restent à 2,50 $/million pour un cache de 5 minutes et 4 $/million pour un cache d'1 heure. L'API Batch applique toujours une remise de 50 % sur l'entrée et la sortie, soit en pratique 1 $/5 $ par million de tokens pour les charges de travail asynchrones.
Nous avons vérifié plusieurs récapitulatifs de prix publiés après le lancement de Sonnet 5.5, et plus d'un, dont le guide tarifaire d'eesel.ai, indique encore 0,20 $ pour les lectures de cache, l'ancien chiffre de Sonnet 5, plutôt que le 0,10 $ corrigé. Si vous budgétez une charge de travail avec un taux élevé de succès de cache, l'écart s'accumule : une charge de travail lisant principalement depuis le cache coûte environ moitié moins qu'un tableau périmé ne le laisserait croire. Vérifiez toute affirmation tarifaire directement auprès de la documentation d'Anthropic plutôt que sur un tableau secondaire, celui-ci inclus, avant d'y engager un budget.
Benchmarks : une quasi-égalité avec Opus, avec un écart fournisseur-vs-indépendant
Benchmark                    Sonnet 5.5   Opus 5.5   Sonnet 5
----------------------------------------------------------------
GDPval-AA v2.1 (knowledge work)    1844         1846        1449
OSWorld 2.1 (partial credit)       80.1%        81.8%       57.0%
OSWorld 2.1 (strict pass)          43.5%        48.7%       25.6%
Terminal-Bench 4.0 (Anthropic)     70.6%        66.4%       10.3%
Terminal-Bench 4.0 (AA re-test)      64%          60%          -
FrontierCode 1.1 (xhigh effort)    52.1%        54.4%       42.4%
CursorBench 4.0                    55.5%        57.8%       34.1%
Humanity's Last Exam (w/ tools)    64.5%        67.7%       54.9%

AA = Artificial Analysis, an independent benchmark lab.
Terminal-Bench shows the largest vendor-vs-independent gap of
any figure checked for this article.
Sur GDPval-AA, un benchmark de travail de connaissance, et OSWorld, un test consistant à piloter un véritable ordinateur via une interface graphique, Sonnet 5.5 se situe à un ou deux points d'Opus 5.5 malgré un coût deux fois moindre. C'est le titre que la plupart des couvertures médiatiques retiennent, et il est exact. Ce que la plupart des couvertures passent sous silence, c'est la ventilation d'OSWorld : le chiffre de 80,1 % correspond au crédit partiel, récompensant la progression vers une tâche même si elle n'est pas pleinement accomplie. Le taux de réussite stricte, achèvement complet de la tâche uniquement, est de 43,5 % pour Sonnet 5.5 contre 48,7 % pour Opus 5.5, un écart qui passe de 1,7 point en crédit partiel à 5,2 points en réussite stricte, un chiffre sensiblement différent à prendre en compte si votre usage exige qu'une tâche soit terminée plutôt que presque terminée.
L'écart sur Terminal-Bench vaut d'être signalé à part. Les documents de lancement d'Anthropic rapportent 70,6 % pour Sonnet 5.5. Artificial Analysis, un laboratoire indépendant qui refait tourner les benchmarks sur son propre harnais plutôt que de prendre les chiffres des fournisseurs pour argent comptant, a mesuré 64 %, une baisse de six points par rapport au chiffre du fournisseur, bien que toujours devant les 60 % d'Opus 5.5 sur le même harnais. Aucun des deux chiffres n'est exactement faux ; ils reflètent des conditions de test différentes. Mais un écart de six points entre ce qu'une entreprise rapporte et ce qu'une partie indépendante reproduit est le genre de détail qui doit figurer dans toute comparaison sérieuse, et il était largement absent des pages concurrentes que nous avons vérifiées.
Un fil Hacker News consacré au lancement (884 points, 613 commentaires) a soulevé une complication connexe : une partie de l'avance de Sonnet 5.5 sur Opus 5.5 sur certains benchmarks agentiques pourrait refléter le comportement de routage de sécurité d'Opus plutôt qu'un pur écart de capacité. Un commentateur a cité Opus 5.5 basculant vers un modèle plus faible dans environ 10 % des essais à cause de déclenchements de garde-fous, bien au-dessus du taux de bascule de Sonnet sur les mêmes tests. C'est une observation de la communauté, pas un chiffre confirmé par Anthropic, mais c'est une explication plausible du pourquoi un modèle moins cher continue de presque égaler, voire de dépasser, un modèle plus cher sur des tests précis.
La vraie histoire de coût : la verbosité en tokens à l'effort maximal
Anthropic présente Sonnet 5.5 comme offrant des tâches jusqu'à 30 % moins chères que Sonnet 5. Cette affirmation est réelle pour le mix de tâches et le niveau d'effort choisis par Anthropic, mais elle ne tient pas universellement, et cet écart est le fait le plus utile de tout cet article pour quiconque paie réellement la facture. Artificial Analysis a mesuré Sonnet 5.5 générant en moyenne environ 193 000 tokens de sortie par tâche à l'effort de raisonnement maximal, le chiffre le plus élevé qu'AA ait enregistré pour n'importe quel modèle qu'elle suit, environ 60 % de plus qu'Opus 5.5 ou Sonnet 5 au même réglage d'effort maximal, et environ sept fois la verbosité de GPT-6 Astra sur des tâches comparables.
Cette verbosité se répercute directement sur le coût par tâche : AA a mesuré Sonnet 5.5 à environ 7,60 $ par tâche à l'effort maximal, environ 50 % plus cher que le coût de Sonnet 5 au même réglage. Sur une comparaison d'AA, Opus 5.5 a atteint le score de qualité maximal de Sonnet 5.5 pour environ 3,46 $ par tâche, nécessitant moins de tokens, mais plus chers, plutôt que beaucoup de tokens moins chers pour y arriver, moins coûteux au total que la propre exécution à effort maximal de Sonnet 5.5. La leçon pratique : l'avantage de prix de Sonnet 5.5 est réel à son réglage par défaut d'effort élevé pour des tâches bien cadrées, et peut disparaître ou s'inverser si vous le poussez à l'effort maximal sur quelque chose de véritablement difficile, où les tokens moins nombreux mais plus chers d'Opus 5.5 finissent parfois le travail pour moins cher.
Sonnet 5.5 contre Opus 5.5 : ce qu'Anthropic elle-même vous dit d'acheter
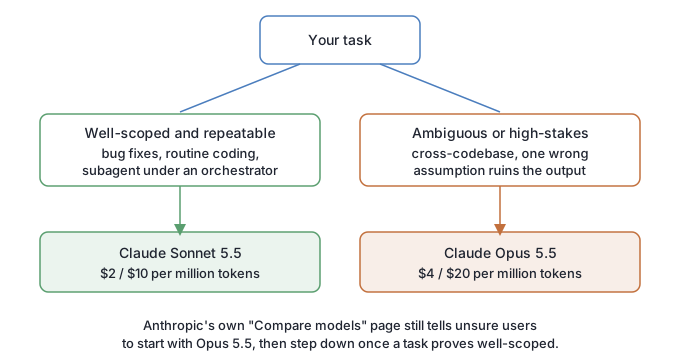
Anthropic ne présente pas Sonnet 5.5 comme un remplacement d'Opus 5.5. Sa propre annonce appelle Sonnet 5.5 « un complément plus rapide et moins coûteux à Claude Opus 5.5 », réservant Opus pour « le travail complexe nécessitant un jugement attentif ». Le tableau comparatif des modèles de la documentation est encore plus direct : il dit aux utilisateurs indécis de commencer avec Opus 5.5 pour la plupart des charges de travail, et traite Sonnet comme le modèle vers lequel on descend une fois qu'on sait déjà qu'une tâche est bien cadrée, pas comme le choix par défaut.
Il y a un véritable compromis de précision derrière cette recommandation, que les tableaux de benchmarks ne montrent pas directement. Sur le test Omniscience d'Artificial Analysis, une mesure de l'exactitude factuelle, Opus 5.5 obtient 66 % contre 54 % pour Sonnet 5.5, Opus connaît simplement plus de faits correctement. Mais sur le taux d'hallucination, Sonnet 5.5 est en fait plus bas (meilleur) à 47 % contre 59 % pour Opus : quand Sonnet 5.5 ne sait pas quelque chose, il est plus susceptible de le dire plutôt que de deviner, même s'il dispose globalement de moins d'éléments pour travailler. Pour la synthèse de recherche en particulier, un taux d'hallucination plus faible sur ce qu'il tente réellement peut compter davantage qu'un plafond de connaissance brute plus élevé, selon que vous préférez repérer une lacune ou repérer une mauvaise réponse énoncée avec assurance.
La plainte qui domine les discussions de développeurs : des garde-fous qui bloquent le travail ordinaire
Le thème récurrent le plus bruyant dans ce fil Hacker News n'était ni le prix ni les benchmarks, c'était le système de garde-fous cyber d'Anthropic signalant du travail légitime comme risqué. Des développeurs ont rapporté avoir été bloqués ou redirigés vers un mode restreint sur des tâches comme du firmware Bluetooth ESP32, la relecture de vieux code C, des implémentations de journal de transactions (write-ahead log), et de la recherche autorisée de bug bounty. Le résumé d'un commentateur, « je ne veux pas d'un outil nounou », a été repris à plusieurs reprises dans le fil, aux côtés de plaintes selon lesquelles le « Cyber Verification Program » sous-jacent produit des faux positifs sans voie de recours claire.
Un second groupe de plaintes portait sur les limites d'usage plutôt que sur le routage de sécurité : plusieurs utilisateurs ont rapporté avoir épuisé leurs quotas de forfait Max bien avant le renouvellement de la période de facturation, l'un citant un forfait Opus 5.5 20x épuisé en quatre jours sur sept, et un autre récit faisant état d'une équipe atteignant un budget mensuel de 10 000 $ de tokens en moins d'une journée d'usage agentique intensif. Aucune de ces plaintes n'est spécifique aux capacités de Sonnet 5.5, mais toutes deux affectent le coût pratique de son adoption au sein d'un flux de travail agentique, et aucune n'apparaît dans un tableau de benchmarks.
Une comparaison menée de façon indépendante donne une idée plus concrète de la fiabilité en conditions réelles. La plateforme de revue de code CodeRabbit a testé Sonnet 5.5 contre Sonnet 5 sur 13 pull requests contenant des bugs connus et préalablement catalogués : Sonnet 5.5 en a détecté 6 sur 13 contre 4 sur 13 pour Sonnet 5, pour un coût par revue environ 60 % plus bas et environ moitié moins de latence (une moyenne de 5 minutes 27 secondes contre 9 minutes 55 secondes). Opus 5.5 en a quand même détecté davantage, 8 à 10 des mêmes 13 bugs selon l'exécution. Cela correspond au schéma décrit par le positionnement même d'Anthropic : Sonnet 5.5 est une véritable amélioration par rapport à Sonnet 5 au même prix, et Opus 5.5 continue d'en détecter davantage sur les cas qui comptent le plus.
Sonnet 5.5 face au reste du marché : GPT-6 Sol et le problème de Pareto
GPT-6 Sol d'OpenAI est au même prix que Sonnet 5.5, 2 $/10 $ par million de tokens, ce qui en fait un duel direct sur le coût. Sonnet 5.5 est clairement en tête sur GDPval-AA (1844 contre 1487) et sur AA-Briefcase (1811 contre 1483), et devance légèrement sur FrontierCode (52,1 % contre 49,3 %). Mais Artificial Analysis note que Sonnet 5.5 se situe en retrait de la frontière intelligence-par-token-de-sortie à prix équivalent, en raison du même problème de verbosité décrit plus haut : GPT-6 Sol délivre plus de capacité mesurée par token de sortie à un niveau de prix comparable, même là où Sonnet 5.5 l'emporte sur les scores de benchmark brut. Lequel coûte réellement moins cher en production dépend fortement de la verbosité que votre charge de travail spécifique laisse le modèle atteindre, pas seulement du tableau de benchmarks principal.
Qui devrait vraiment utiliser Sonnet 5.5
- Utilisez Sonnet 5.5 si votre charge de travail est bien cadrée et répétable : codage de routine, correction de bugs avec un cas de reproduction clair, ou un sous-agent fonctionnant sous un orchestrateur de niveau Opus. C'est là que ses scores de benchmark proches d'Opus, à moitié prix, rapportent réellement.
- Utilisez Sonnet 5.5 si vous étiez déjà sur Sonnet 5 et n'avez rien changé. La mise à niveau est en pratique gratuite sur l'alias de modèle
sonnet, et les tests indépendants (la comparaison de revue de PR de CodeRabbit, un test pratique séparé d'agent d'édition) montrent un véritable saut de qualité au même prix. - Passez à Opus 5.5 si la tâche est ambiguë, s'étend sur une base de code inconnue, ou si une seule hypothèse erronée serait coûteuse. L'avance d'Opus sur Sonnet s'élargit précisément sur ces cas plus difficiles et moins cadrés.
- Ne tenez pas pour acquis le « jusqu'à 30 % moins cher » à l'effort maximal. Si vous poussez Sonnet 5.5 à son réglage de raisonnement le plus élevé sur des problèmes véritablement difficiles, vérifiez votre consommation réelle de tokens. Une mesure indépendante a constaté qu'il peut coûter plus cher que Sonnet 5, et parfois plus cher qu'Opus 5.5 atteignant le même résultat.
- Budgétez les charges de travail à forte utilisation de cache avec 0,10 $/million pour les lectures, et non le chiffre de 0,20 $ que plusieurs trackers de prix publient encore.
Questions fréquentes
Quand Claude Sonnet 5.5 a-t-il été lancé, et avant ou après Opus 5.5 ?
Le 28 septembre 2026, six jours après Claude Opus 5.5 (22 septembre 2026), et non avant lui. Une version antérieure de notre propre guide sur Opus 5.5 indiquait l'ordre inverse ; nous l'avons corrigé après vérification auprès de la documentation même d'Anthropic.
Combien coûte Claude Sonnet 5.5 ?
2 $ par million de tokens en entrée et 10 $ par million de tokens en sortie, inchangé par rapport à Sonnet 5. Les lectures de cache de prompt coûtent 0,10 $ par million de tokens, la moitié de l'ancien tarif de 0,20 $ de Sonnet 5, un changement que plusieurs trackers de prix tiers n'ont toujours pas mis à jour. L'API Batch applique une remise de 50 % en plus des tarifs standard.
Claude Sonnet 5.5 est-il aussi bon qu'Opus 5.5 ?
Sur GDPval-AA (travail de connaissance) et OSWorld (usage d'ordinateur), Sonnet 5.5 obtient des scores à un ou deux points de ceux d'Opus 5.5, malgré un coût deux fois moindre. Opus 5.5 prend l'avantage sur les benchmarks plus difficiles et moins cadrés, et sur l'exactitude factuelle (66 % contre 54 % sur AA-Omniscience), tandis que Sonnet 5.5 hallucine en fait moins quand il ne connaît pas la réponse (47 % contre 59 %).
Claude Sonnet 5.5 est-il vraiment jusqu'à 30 % moins cher que Sonnet 5 ?
Pour le mix de tâches et le niveau d'effort par défaut choisis par Anthropic, oui. À l'effort de raisonnement maximal, des tests indépendants ont constaté que Sonnet 5.5 génère beaucoup plus de tokens de sortie par tâche que Sonnet 5, poussant son coût par tâche environ 50 % plus haut que Sonnet 5 à ce réglage, et parfois plus haut qu'Opus 5.5 atteignant la même qualité avec moins de tokens.
Pourquoi les utilisateurs se plaignent-ils des garde-fous cyber de Claude sur Sonnet et Opus 5.5 ?
Des développeurs ont rapporté que du travail légitime, code de firmware, relecture de vieux C, recherche de sécurité autorisée, se voyait signalé ou restreint par le Cyber Verification Program d'Anthropic. La plainte ne porte pas sur une réponse erronée en particulier ; elle porte sur des faux positifs qui interrompent le travail de développement ordinaire sans voie claire pour les résoudre.
Exportez votre NotebookLM en un clic
Extension Chrome gratuite. PDF, Word et Markdown. Généré sur votre machine — rien n'est envoyé en ligne.