Claude Sonnet 5.5, समझाया गया: वह सस्ता मॉडल जो Anthropic के अपने फ़्लैगशिप को बार-बार शर्मिंदा करता रहता है
Anthropic ने Claude Sonnet 5.5 को 28 सितंबर 2026 को जारी किया — Claude Opus 5.5 से छह दिन बाद, पहले नहीं — उसी $2 इनपुट / $10 आउटपुट प्रति मिलियन टोकन की क़ीमत पर जो उस Sonnet की थी जिसकी जगह यह लेता है। रोज़मर्रा के काम के लिए सबसे ज़्यादा मायने रखने वाले दो बेंचमार्क पर, यह Opus 5.5 के दो पॉइंट के दायरे में आता है — एक ऐसा मॉडल जिसकी क़ीमत दोगुनी है। वह पेच जिसे प्रतिस्पर्धी बार-बार मिस कर रहे हैं: Anthropic की अपनी सबसे ऊंची रीज़निंग-एफ़र्ट सेटिंग पर, Sonnet 5.5 प्रति टास्क इतने ज़्यादा टोकन जला देता है कि क़ीमत वाली बढ़त पूरी तरह उलट सकती है।
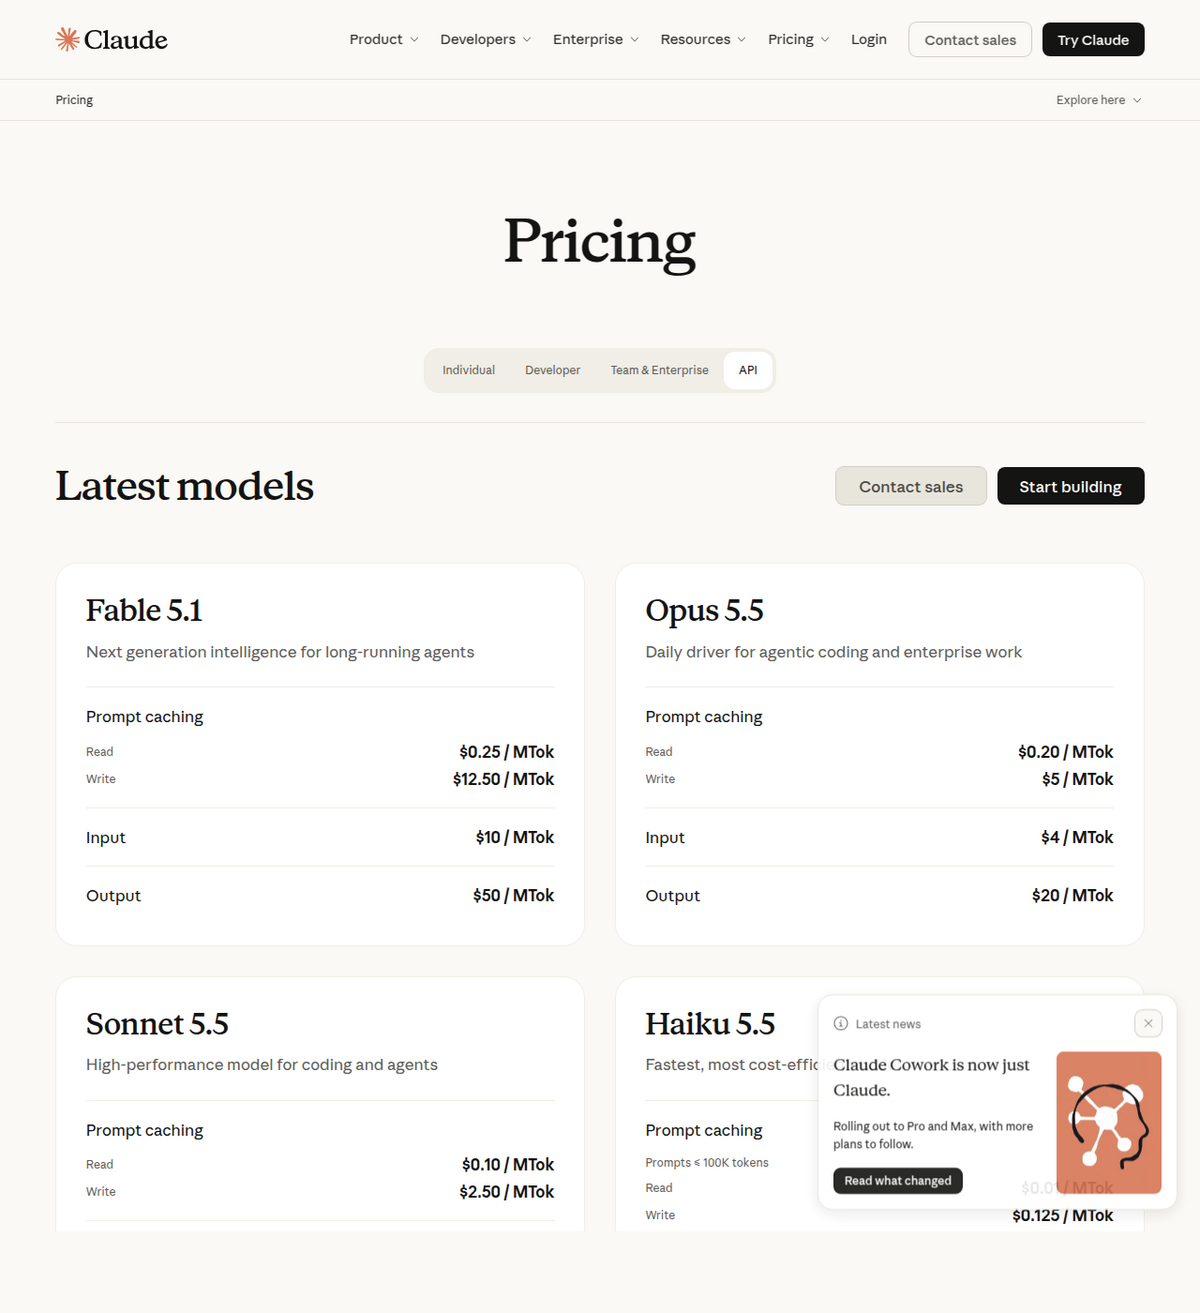
Claude Sonnet 5.5, 28 सितंबर 2026 को लॉन्च हुआ, Anthropic के "5.5" रीफ़्रेश में दूसरी रिलीज़, Opus 5.5 (22 सितंबर) से छह दिन बाद। क़ीमत Sonnet 5 से नहीं बदली: $2 प्रति मिलियन इनपुट टोकन, $10 प्रति मिलियन आउटपुट टोकन। जो एक क़ीमत बदली वह आसानी से नज़र से छूट जाती है: कैश्ड-प्रॉम्प्ट रीड्स गिरकर $0.10 प्रति मिलियन टोकन हो गए — Sonnet 5 की पुरानी $0.20 दर से आधी। हमने जो ज़्यादातर थर्ड-पार्टी प्राइसिंग ट्रैकर जांचे, वे अब भी $0.20 को मौजूदा दर बताते हैं।
नॉलेज-वर्क और कंप्यूटर-यूज़ बेंचमार्क पर, यह आधी क़ीमत में Opus 5.5 के लगभग बराबर है। Sonnet 5.5, GDPval-AA v2.1 पर 1844 स्कोर करता है जबकि Opus का स्कोर 1846 है, और OSWorld 2.1 पर 80.1% बनाम Opus के 81.8% — यानी 2x क़ीमत के फ़र्क़ के बावजूद एक से दो पॉइंट का ही फ़र्क़।
Anthropic के अपने वेंडर नंबर और एक स्वतंत्र लैब के दोबारा टेस्ट के नतीजे मेल नहीं खाते। Anthropic, Terminal-Bench 4.0 पर 70.6% रिपोर्ट करता है; Artificial Analysis ने उसी बेंचमार्क को अपने हार्नेस पर दोबारा चलाया और 64% पाया — यह अब भी AA के हार्नेस पर Opus 5.5 के 60% से आगे है, पर मार्केटिंग नंबर और दोहराए गए नतीजे के बीच यह असली फ़र्क़ जानने लायक़ है, इससे पहले कि आप इसके आधार पर कोई योजना बनाएं।
"30% तक सस्ता" वाला दावा हर सेटिंग पर सही नहीं बैठता। मैक्सिमम रीज़निंग एफ़र्ट पर, Sonnet 5.5 औसतन प्रति टास्क लगभग 193,000 आउटपुट टोकन जनरेट करता है — Artificial Analysis ने किसी भी मॉडल के लिए मापा सबसे ऊंचा आंकड़ा — जिससे इसकी प्रति-टास्क लागत लगभग $7.60 तक पहुंच जाती है, जो Sonnet 5 से ज़्यादा है, और एक माप में, Opus 5.5 से भी ज़्यादा — जो कम पर ज़्यादा महंगे टोकन इस्तेमाल करके वही क्वालिटी बार हासिल कर लेता है।
क्या शिप हुआ, और किस क्रम में
हमारी अपनी Opus 5.5 गाइड में यह क्रम उलटा लिखा था, जब तक हमने इस लेख पर रिसर्च करते वक़्त इसे ठीक नहीं किया। Anthropic का अपना मॉडल डॉक्यूमेंटेशन Opus 5.5 की रिलीज़ 22 सितंबर 2026 और Sonnet 5.5 की रिलीज़ 28 सितंबर 2026 बताता है — यानी छह दिन बाद, पहले नहीं। यह क्रम इस बात के लिए मायने रखता है कि तुलना को कैसे पढ़ा जाए: Sonnet 5.5 वह फ़ॉलो-अप एक्ट है जिसे Opus 5.5 के बेंचमार्क नंबर को पीछे छोड़ना था, कोई वार्म-अप नहीं।
API मॉडल ID है claude-sonnet-5-5, जो Claude API, Amazon Bedrock, Google Cloud Vertex AI, और Microsoft Foundry के ज़रिए उपलब्ध है। कॉन्टेक्स्ट विंडो 1 मिलियन टोकन पर बनी हुई है, स्टैंडर्ड रिक्वेस्ट पर 128K-टोकन की आउटपुट लिमिट के साथ, जिसे Batch API पर output-300k-2026-03-24 बीटा हेडर के पीछे 300K टोकन तक बढ़ाया जा सकता है। नॉलेज कटऑफ़ ट्रेनिंग और भरोसेमंद-रीकॉल दोनों मक़सद के लिए जून 2026 है। Sonnet 5 से एक बिहेवियरल डिफ़ॉल्ट बदला: Sonnet 5.5 डिफ़ॉल्ट रूप से हाई एफ़र्ट पर रीज़न करता है (Opus 5.5 का डिफ़ॉल्ट मीडियम है), और इसकी सबसे कम मैनुअल थिंकिंग सेटिंग अब पुराने disabled ऑप्शन की बजाय between_tools है — यह एक ब्रेकिंग चेंज है अगर आपके इंटीग्रेशन ने साफ़ तौर पर थिंकिंग को ऑफ़ सेट किया था।
क़ीमत वाला पेच: कैश रीड्स सस्ते हुए, और ज़्यादातर ट्रैकर इसे मिस कर गए
इनपुट और आउटपुट प्राइसिंग Sonnet 5 से बिना बदलाव आगे बढ़ी: $2 प्रति मिलियन इनपुट टोकन, $10 प्रति मिलियन आउटपुट। प्रॉम्प्ट कैशिंग ही वह जगह है जहां असल में कुछ बदला। Anthropic का डॉक्यूमेंटेशन कहता है कि Sonnet 5.5, Sonnet 5 जैसी ही क़ीमतें रखता है, "सिवाय प्रॉम्प्ट कैश रीड्स के, जिनकी क़ीमत $0.10 प्रति मिलियन टोकन है, Claude Sonnet 5 की दर से आधी।" कैश राइट्स 5-मिनट वाले कैश के लिए $2.50/मिलियन और 1-घंटे वाले कैश के लिए $4/मिलियन पर बने हुए हैं। Batch API अब भी इनपुट और आउटपुट दोनों पर 50% डिस्काउंट लगाता है, यानी असिंक्रोनस वर्कलोड के लिए असल में $1/$5 प्रति मिलियन टोकन।
हमने Sonnet 5.5 के लॉन्च के बाद प्रकाशित हुए कई प्राइसिंग राउंड-अप जांचे, और एक से ज़्यादा में, जिसमें eesel.ai की प्राइसिंग गाइड शामिल है, अब भी कैश रीड्स $0.20 पर बताए गए हैं — Sonnet 5 का पुराना आंकड़ा — न कि सही किया गया $0.10। अगर आप किसी ऐसे वर्कलोड के लिए बजट बना रहे हैं जिसमें कैश-हिट-रेट ज़्यादा है, तो यह फ़र्क़ और बड़ा हो जाता है: जो वर्कलोड ज़्यादातर कैश से रीड करता है, उसकी लागत एक पुराने चार्ट के अंदाज़े से लगभग आधी होती है। किसी भी प्राइसिंग दावे को, इस आर्टिकल को भी शामिल करते हुए, किसी सेकंडरी टेबल की बजाय सीधे Anthropic के अपने डॉक्स से जांच लें, इससे पहले कि आप उसके आधार पर बजट तय करें।
बेंचमार्क: Opus के लगभग बराबर, एक वेंडर-बनाम-स्वतंत्र फ़र्क़ के साथ
Benchmark                    Sonnet 5.5   Opus 5.5   Sonnet 5
----------------------------------------------------------------
GDPval-AA v2.1 (knowledge work)    1844         1846        1449
OSWorld 2.1 (partial credit)       80.1%        81.8%       57.0%
OSWorld 2.1 (strict pass)          43.5%        48.7%       25.6%
Terminal-Bench 4.0 (Anthropic)     70.6%        66.4%       10.3%
Terminal-Bench 4.0 (AA re-test)      64%          60%          -
FrontierCode 1.1 (xhigh effort)    52.1%        54.4%       42.4%
CursorBench 4.0                    55.5%        57.8%       34.1%
Humanity's Last Exam (w/ tools)    64.5%        67.7%       54.9%

AA = Artificial Analysis, एक स्वतंत्र बेंचमार्क लैब।
Terminal-Bench, इस आर्टिकल के लिए जांचे गए किसी भी आंकड़े के बीच
सबसे बड़ा वेंडर-बनाम-स्वतंत्र फ़र्क़ दिखाता है।
GDPval-AA पर, जो एक नॉलेज-वर्क बेंचमार्क है, और OSWorld पर, जो GUI के ज़रिए असली कंप्यूटर चलाने का टेस्ट है, Sonnet 5.5 आधी क़ीमत के बावजूद Opus 5.5 के एक से दो पॉइंट के दायरे में आता है। ज़्यादातर कवरेज इसी हेडलाइन से शुरू होती है, और यह सही भी है। जो बात ज़्यादातर कवरेज छोड़ देती है वह OSWorld का बंटवारा है: 80.1% वाला आंकड़ा पार्शियल क्रेडिट है, जो किसी टास्क की तरफ़ बढ़त को इनाम देता है भले ही वह पूरी तरह पूरा न हुआ हो। स्ट्रिक्ट पास रेट — यानी सिर्फ़ पूरा हुआ टास्क — Sonnet 5.5 के लिए 43.5% है बनाम Opus 5.5 के 48.7% के, एक ऐसा फ़र्क़ जो पार्शियल क्रेडिट पर 1.7 पॉइंट से बढ़कर स्ट्रिक्ट पास पर 5.2 पॉइंट हो जाता है — एक काफ़ी अलग नंबर जिसे ध्यान में रखना चाहिए अगर आपके इस्तेमाल के लिए टास्क पूरा होना ज़रूरी है, सिर्फ़ ज़्यादातर पूरा नहीं।
Terminal-Bench वाला फ़र्क़ अपने आप में झंडी दिखाने लायक़ है। Anthropic की लॉन्च सामग्री Sonnet 5.5 के लिए 70.6% रिपोर्ट करती है। Artificial Analysis, एक स्वतंत्र लैब जो वेंडर नंबर को सीधे मान लेने की बजाय बेंचमार्क को अपने ही हार्नेस पर दोबारा चलाती है, ने 64% मापा — वेंडर के आंकड़े से छह पॉइंट कम, फिर भी उसी हार्नेस पर Opus 5.5 के 60% से आगे। दोनों में से कोई नंबर ठीक-ठीक ग़लत नहीं है; वे अलग-अलग टेस्ट कंडीशन दिखाते हैं। पर किसी कंपनी के रिपोर्ट किए नंबर और किसी स्वतंत्र पक्ष के दोहराए नतीजे के बीच छह पॉइंट का फ़र्क़ वह जानकारी है जो किसी भी गंभीर तुलना में होनी चाहिए, और जिन प्रतिस्पर्धी पेजों को हमने जांचा उनमें यह ज़्यादातर गायब थी।
लॉन्च पर चर्चा करने वाले एक Hacker News थ्रेड (884 पॉइंट, 613 कमेंट) ने एक जुड़ी हुई बात उठाई: कुछ एजेंटिक बेंचमार्क पर Opus 5.5 के मुक़ाबले Sonnet 5.5 की बढ़त का कुछ हिस्सा शुद्ध क्षमता के फ़र्क़ की बजाय Opus के सेफ़्टी-रूटिंग बिहेवियर की वजह से हो सकता है। एक कमेंटर ने बताया कि Opus 5.5, सेफ़गार्ड ट्रिगर होने की वजह से लगभग 10% ट्रायल में एक कमज़ोर मॉडल पर फ़ॉलबैक कर जाता है — उसी टेस्ट पर Sonnet के फ़ॉलबैक रेट से काफ़ी ऊपर। यह एक सामुदायिक ऑब्ज़र्वेशन है, Anthropic की पुष्टि किया हुआ आंकड़ा नहीं, पर यह एक मुमकिन वजह है कि आख़िर एक सस्ता मॉडल कुछ ख़ास टेस्ट पर एक महंगे मॉडल के लगभग बराबर या उससे थोड़ा आगे क्यों बना रहता है।
असली लागत वाली कहानी: मैक्स एफ़र्ट पर टोकन वर्बोसिटी
Anthropic, Sonnet 5.5 को इस तरह मार्केट करता है कि यह Sonnet 5 के मुक़ाबले टास्क 30% तक कम लागत पर पूरे करता है। यह दावा Anthropic के चुने हुए टास्क मिक्स और एफ़र्ट लेवल पर सही है, पर यह हर जगह लागू नहीं होता, और यह फ़र्क़ इस आर्टिकल का सबसे ज़्यादा काम का तथ्य है उन सबके लिए जो असल में बिल चुकाते हैं। Artificial Analysis ने मापा कि Sonnet 5.5, मैक्सिमम रीज़निंग एफ़र्ट पर औसतन प्रति टास्क लगभग 193,000 आउटपुट टोकन जनरेट करता है — AA ने जिस भी मॉडल को ट्रैक किया है उसके लिए यह सबसे ऊंचा आंकड़ा है — जो उसी मैक्स-एफ़र्ट सेटिंग पर Opus 5.5 या Sonnet 5 से लगभग 60% ज़्यादा है, और तुलनीय टास्क पर GPT-6 Astra की वर्बोसिटी से लगभग सात गुना।
यह वर्बोसिटी सीधे प्रति-टास्क लागत में दिखती है: AA ने मैक्स एफ़र्ट पर Sonnet 5.5 को लगभग $7.60 प्रति टास्क मापा — उसी सेटिंग पर Sonnet 5 की लागत से लगभग 50% ज़्यादा। AA की एक तुलना में, Opus 5.5 ने Sonnet 5.5 के सबसे ऊंचे क्वालिटी स्कोर तक लगभग $3.46 प्रति टास्क में पहुंच पाया — वहां तक पहुंचने के लिए ज़्यादा सस्ते टोकन की बड़ी तादाद की बजाय कम पर ज़्यादा महंगे टोकन इस्तेमाल करते हुए — जो कुल मिलाकर Sonnet 5.5 के अपने मैक्स-एफ़र्ट रन से भी सस्ता निकला। व्यावहारिक सीख यह है: साफ़ दायरे वाले टास्क के लिए Sonnet 5.5 की क़ीमत वाली बढ़त इसकी डिफ़ॉल्ट हाई-एफ़र्ट सेटिंग पर असली है, और अगर आप इसे किसी सचमुच मुश्किल चीज़ पर मैक्स एफ़र्ट तक धकेलते हैं तो यह ख़त्म हो सकती है या उलट सकती है, जहां Opus 5.5 के कम पर ज़्यादा महंगे टोकन कभी-कभी काम को कम में पूरा कर देते हैं।
Sonnet 5.5 बनाम Opus 5.5: Anthropic ख़ुद आपको क्या ख़रीदने को कहता है
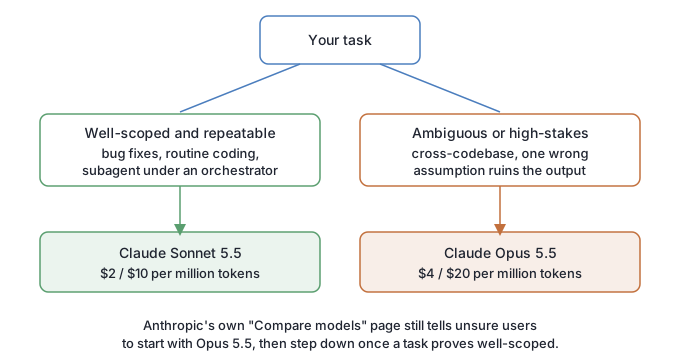
Anthropic, Sonnet 5.5 को Opus 5.5 के किसी रिप्लेसमेंट की तरह पेश नहीं करता। उसका अपना अनाउंसमेंट, Sonnet 5.5 को "Claude Opus 5.5 का एक तेज़, कम-लागत वाला कॉम्प्लिमेंट" कहता है, और Opus को "सावधान फ़ैसले की ज़रूरत वाले मुश्किल काम" के लिए रखता है। डॉक्यूमेंटेशन की मॉडल-तुलना वाली टेबल और भी साफ़ है: यह अनिश्चित यूज़र्स को ज़्यादातर वर्कलोड के लिए Opus 5.5 से शुरुआत करने को कहती है, और Sonnet को वह मॉडल मानती है जिस पर आप तभी नीचे उतरते हैं जब आपको पहले से पता हो कि किसी टास्क का दायरा साफ़ है — यह डिफ़ॉल्ट चुनाव नहीं है।
इस गाइडेंस के पीछे एक असली एक्यूरेसी ट्रेडऑफ़ है जो बेंचमार्क टेबल सीधे नहीं दिखाती। Artificial Analysis के Omniscience टेस्ट पर, जो फ़ैक्चुअल एक्यूरेसी मापता है, Opus 5.5, Sonnet 5.5 के 54% के मुक़ाबले 66% स्कोर करता है — यानी Opus को सीधे-सीधे ज़्यादा तथ्य सही से पता हैं। पर हैलुसिनेशन रेट पर, Sonnet 5.5 असल में कम (यानी बेहतर) है — 47% बनाम Opus के 59% — जब Sonnet 5.5 को कुछ नहीं पता होता, तो वह अंदाज़ा लगाने की बजाय यह कहने की ज़्यादा संभावना रखता है कि उसे नहीं पता, भले ही उसके पास काम करने के लिए कुल मिलाकर कम जानकारी हो। ख़ासतौर पर रिसर्च सिंथेसिस के लिए, जो कुछ यह कोशिश करता है उस पर कम हैलुसिनेशन रेट, ज़्यादा कच्ची-नॉलेज वाली सीमा से कहीं ज़्यादा मायने रख सकता है — यह इस पर निर्भर करता है कि आप किसी ख़ाली जगह को पकड़ना पसंद करते हैं या भरोसे से कहे गए किसी ग़लत जवाब को।
डेवलपर चर्चा पर छाई शिकायत: सेफ़गार्ड आम काम को ब्लॉक कर रहे हैं
उस Hacker News थ्रेड में सबसे ज़्यादा दोहराई जाने वाली थीम क़ीमत या बेंचमार्क नहीं थी, बल्कि Anthropic का साइबर-सेफ़गार्ड सिस्टम था जो सही-सही काम को जोख़िम भरा बताकर फ़्लैग कर रहा था। डेवलपर्स ने ESP32 Bluetooth फ़र्मवेयर, पुराने C कोड की रिव्यू, वाइट-अहेड-लॉग इम्प्लीमेंटेशन, और अधिकृत बग-बाउंटी रिसर्च जैसे टास्क पर ब्लॉक होने या किसी प्रतिबंधित मोड में भेज दिए जाने की शिकायत की। एक कमेंटर का सार, "मुझे कोई नैनी टूल नहीं चाहिए," पूरे थ्रेड में बार-बार गूंजा, साथ ही यह शिकायत भी कि अंतर्निहित "Cyber Verification Program" बिना किसी साफ़ अपील के रास्ते के फ़ॉल्स पॉज़िटिव्स पैदा करता है।
शिकायतों का एक दूसरा समूह सेफ़्टी रूटिंग की बजाय इस्तेमाल की सीमाओं पर केंद्रित था: कई यूज़र्स ने बताया कि उनका Max-प्लान कोटा बिलिंग पीरियड रीन्यू होने से काफ़ी पहले ख़त्म हो गया — एक ने बताया कि उसका Opus 5.5 20x प्लान सात में से चार दिन में ख़त्म हो गया, और एक अलग मामले में किसी टीम ने भारी एजेंटिक इस्तेमाल में एक दिन से भी कम वक़्त में $10,000 का महीने भर का टोकन बजट ख़त्म कर दिया। दोनों में से कोई शिकायत ख़ासतौर पर Sonnet 5.5 की क्षमताओं की नहीं है, पर दोनों किसी एजेंटिक वर्कफ़्लो के अंदर इसे अपनाने की व्यावहारिक लागत को प्रभावित करती हैं, और दोनों किसी बेंचमार्क चार्ट में नहीं दिखतीं।
एक स्वतंत्र रूप से चलाई गई तुलना असली-दुनिया की भरोसेमंदी का ज़्यादा ठोस अंदाज़ा देती है। कोड-रिव्यू प्लेटफ़ॉर्म CodeRabbit ने टेस्ट किया Sonnet 5.5 को Sonnet 5 के मुक़ाबले, 13 पुल रिक्वेस्ट पर जिनमें पहले से पहचाने गए और सूचीबद्ध बग थे: Sonnet 5.5 ने 13 में से 6 पकड़े, Sonnet 5 के 13 में से 4 के मुक़ाबले, और वह भी प्रति रिव्यू लगभग 60% कम लागत पर और क़रीब आधी लेटेंसी पर (औसतन 5 मिनट 27 सेकंड बनाम 9 मिनट 55 सेकंड)। Opus 5.5 ने अब भी ज़्यादा पकड़े — रन के हिसाब से उन्हीं 13 में से 8 से 10 बग। यह उस पैटर्न से मेल खाता है जो Anthropic की अपनी पोज़िशनिंग बताती है: Sonnet 5.5, Sonnet 5 के मुक़ाबले उसी क़ीमत पर एक असली अपग्रेड है, और Opus 5.5 अब भी उन मामलों में ज़्यादा पकड़ता है जो सबसे ज़्यादा मायने रखते हैं।
Sonnet 5.5 बाकी मैदान के मुक़ाबले: GPT-6 Sol और पैरेटो वाली समस्या
OpenAI का GPT-6 Sol, Sonnet 5.5 जैसी ही $2/$10 प्रति मिलियन टोकन क़ीमत पर है, जिससे क़ीमत के मामले में दोनों का सीधा मुक़ाबला बनता है। Sonnet 5.5, GDPval-AA पर साफ़ तौर पर आगे है (1844 बनाम 1487) और AA-Briefcase पर भी (1811 बनाम 1483), और FrontierCode पर थोड़ा आगे (52.1% बनाम 49.3%)। पर Artificial Analysis बताता है कि बराबर क़ीमत पर Sonnet 5.5, इंटेलिजेंस-पर-आउटपुट-टोकन फ़्रंटियर से बाहर बैठता है, उसी वर्बोसिटी वाली समस्या की वजह से जिसका ज़िक्र ऊपर हुआ: GPT-6 Sol, तुलनीय क़ीमत पर प्रति आउटपुट टोकन ज़्यादा मापी गई क्षमता देता है, वहां भी जहां Sonnet 5.5, कच्चे बेंचमार्क स्कोर पर जीतता है। प्रोडक्शन में असल में किसकी लागत कम पड़ती है, यह काफ़ी हद तक इस पर निर्भर करता है कि आपका ख़ास वर्कलोड मॉडल को कितना वर्बोस होने देता है, सिर्फ़ हेडलाइन बेंचमार्क टेबल पर नहीं।
Sonnet 5.5 असल में किसे इस्तेमाल करना चाहिए
- Sonnet 5.5 इस्तेमाल करें अगर आपका वर्कलोड साफ़ दायरे वाला और दोहराने लायक़ है: रूटीन कोडिंग, साफ़ रीप्रोडक्शन केस वाले बग फ़िक्स, या किसी Opus-लेवल ऑर्केस्ट्रेटर के नीचे चलने वाला सबएजेंट। यहीं इसके आधी क़ीमत पर Opus के क़रीब बेंचमार्क स्कोर असल में फ़ायदा देते हैं।
- Sonnet 5.5 इस्तेमाल करें अगर आप पहले से Sonnet 5 पर हैं और कुछ बदला नहीं है।
sonnetमॉडल एलियास पर यह अपग्रेड व्यावहारिक रूप से मुफ़्त है, और स्वतंत्र टेस्टिंग (CodeRabbit की PR रिव्यू तुलना, एक अलग हैंड्स-ऑन एडिटिंग-एजेंट टेस्ट) उसी क़ीमत पर एक असली क्वालिटी जंप दिखाती है। - Opus 5.5 पर एस्केलेट करें अगर टास्क अस्पष्ट है, किसी अनजान कोडबेस में फ़ैला है, या एक भी ग़लत अनुमान महंगा पड़ सकता है। ठीक इन्हीं मुश्किल, कम-साफ़-दायरे वाले मामलों पर Sonnet के मुक़ाबले Opus की बढ़त और चौड़ी हो जाती है।
- मैक्स एफ़र्ट पर "30% तक सस्ता" मान कर न चलें। अगर आप Sonnet 5.5 को सचमुच मुश्किल समस्याओं पर इसकी सबसे ऊंची रीज़निंग सेटिंग तक धकेल रहे हैं, तो अपना असली टोकन ख़र्च जांचें। स्वतंत्र माप में पाया गया कि यह Sonnet 5 से ज़्यादा महंगा पड़ सकता है, और कभी-कभी वही नतीजा हासिल करने वाले Opus 5.5 से भी ज़्यादा।
- कैश-हेवी वर्कलोड का बजट रीड्स के लिए $0.10/मिलियन मानकर बनाएं, न कि वह $0.20 वाला आंकड़ा जो कई प्राइसिंग ट्रैकर अब भी प्रकाशित कर रहे हैं।
लोग यह भी पूछते हैं
Claude Sonnet 5.5 कब लॉन्च हुआ, और Opus 5.5 से पहले या बाद में?
28 सितंबर 2026, Claude Opus 5.5 (22 सितंबर 2026) से छह दिन बाद, पहले नहीं। हमारी अपनी Opus 5.5 गाइड के एक पहले वर्ज़न में यह क्रम उलटा था; Anthropic के अपने डॉक्यूमेंटेशन से पुष्टि करने के बाद हमने इसे ठीक किया।
Claude Sonnet 5.5 की क़ीमत कितनी है?
$2 प्रति मिलियन इनपुट टोकन और $10 प्रति मिलियन आउटपुट टोकन, Sonnet 5 से बिना बदलाव। कैश्ड-प्रॉम्प्ट रीड्स की क़ीमत $0.10 प्रति मिलियन टोकन है, Sonnet 5 की पुरानी $0.20 दर से आधी — एक ऐसा बदलाव जिसे कई थर्ड-पार्टी प्राइसिंग ट्रैकर अब भी अपडेट नहीं कर पाए हैं। Batch API, स्टैंडर्ड प्राइसिंग के ऊपर 50% डिस्काउंट लगाता है।
क्या Claude Sonnet 5.5, Opus 5.5 जितना अच्छा है?
GDPval-AA (नॉलेज-वर्क) और OSWorld (कंप्यूटर-यूज़) पर, Sonnet 5.5, आधी क़ीमत के बावजूद Opus 5.5 के एक से दो पॉइंट के दायरे में स्कोर करता है। Opus 5.5, मुश्किल और कम-साफ़-दायरे वाले बेंचमार्क पर और फ़ैक्चुअल एक्यूरेसी पर (AA-Omniscience पर 66% बनाम 54%) आगे निकल जाता है, जबकि Sonnet 5.5 असल में तब कम हैलुसिनेट करता है जब उसे किसी जवाब का पता नहीं होता (47% बनाम 59%)।
क्या Claude Sonnet 5.5 सचमुच Sonnet 5 से 30% तक सस्ता है?
Anthropic के चुने हुए टास्क मिक्स और डिफ़ॉल्ट एफ़र्ट लेवल पर, हां। मैक्सिमम रीज़निंग एफ़र्ट पर, स्वतंत्र टेस्टिंग में पाया गया कि Sonnet 5.5, Sonnet 5 के मुक़ाबले प्रति टास्क कहीं ज़्यादा आउटपुट टोकन जनरेट करता है, जिससे उस सेटिंग पर इसकी प्रति-टास्क लागत Sonnet 5 से लगभग 50% ज़्यादा हो जाती है, और कभी-कभी कम टोकन में वही क्वालिटी हासिल करने वाले Opus 5.5 से भी ज़्यादा।
लोग Sonnet और Opus 5.5 के साइबर सेफ़गार्ड की शिकायत क्यों करते हैं?
डेवलपर्स ने बताया है कि सही-सही काम — फ़र्मवेयर कोड, पुराने C की रिव्यू, अधिकृत सिक्योरिटी रिसर्च — Anthropic के Cyber Verification Program से फ़्लैग या प्रतिबंधित हो जाता है। यह शिकायत किसी ख़ास ग़लत जवाब की नहीं है; यह इस बात की है कि फ़ॉल्स पॉज़िटिव्स बिना किसी साफ़ हल के रास्ते के आम डेवलपमेंट काम में रुकावट डालते हैं।
एक क्लिक में अपना NotebookLM एक्सपोर्ट करें
मुफ़्त Chrome एक्सटेंशन। PDF, Word और Markdown। आपकी मशीन पर ही रेंडर होता है — कुछ भी अपलोड नहीं होता।